4. Лучшие ИИ (нейросети) для генерации картинок, видео, музыки и 3D моделей (краткое описание готовых шаблонов ComfyUI для генерации фото и видео на своём компьютере)
Как генерировать фото, видео, музыку и 3D модели с помощью нейросетей на своём компьютере (руководство по ComfyUI). Полное оглавление
- Как использовать нейросети для создания изображений, видео и музыки на своём компьютере — что для этого нужно и какой результат можно получить
- Как установить ComfyUI в Windows и Linux
- Виды ИИ (нейросетей) для генерации картинок и видео. Основные термины
- Лучшие ИИ (нейросети) для генерации картинок, видео, музыки и 3D моделей (краткое описание готовых шаблонов ComfyUI для генерации фото и видео на своём компьютере)
4.2 Изображение в изображение (I2I)
4.5 Первый и последний кадр в видео (FLF2V)
4.10 Изображение в 3D модель (I2M)
4.11 Несколько изображений в 3D модель (MV2M)
- Знакомство с ComfyUI
- Основы генерации изображений из текстовых запросов на своём компьютере
- Расширение области видимости изображений с помощью нейросетей (расширение кадра, изменение соотношения сторон с добавлением новой информации — outpainting)
- Замена, удаление и добавление объектов на изображение с помощью ИИ — редактирование по маске (inpainting)
- Редактирование изображения с помощью нейросетей (I2I)
- Междоменный перевод изображений (преобразование между различными типами изображений)
- Превращение нефотографических изображений в фотографии (фотореалистичные изображения) с помощью ИИ
- Ускорение создания и редактирования изображений с помощью дистиллированных моделей нейросетей
- Генерация изображений с текстом. Добавление текста на изображение и редактирование текста с помощью нейросетей
- Использование одного или нескольких референсов для генерации картинок: изменение фона, изменение и дорисовка объектов и персонажей, замена стиля, расширение кадра, перенос стиля между картинками, объединение нескольких изображений в одно
- Восстановление и улучшение изображений с помощью ИИ: устранение повреждений фотографий, превращение чёрно-белой фотографии в цветную, улучшение и усиление цветов, увеличение размера изображения
- Редактирование изображений через декомпозицию сцены
- Генерация изображений из других изображений с применением ControlNet, IP-Adapter и IP-Control
- Физически правдоподобное редактирование изображений с ChronoEdit 14B (Physics-driven image editing)
- Основы создания видео из текстовых запросов на своём компьютере
- Основы генерации видео из изображений на своём компьютере
- Создание видео из первого и последнего кадров
- Редактирование видео с помощью нейросетей — замена и удаление элементов (генерация видео из видео)
- Создание видео с контролем камеры
- Создание видео с контролем движений
- Методы создания длинных видео с помощью ИИ
- Создание музыки по словесному описанию. Создание песен из ваших стихов. Редактирование существующих песен (стиля и слов)
- Создание 3D моделей из изображений
- Продвинутые техники написания промптов
- Детальное управление жанром, кадровкой, ракурсом, композицией, расположением камеры, освещением, скоростью съёмки, движениями камеры, позиционированием и пластикой тела и прочим в промптах
- Типы моделей нейросетей. Квантование. Общие принципы использования дообученных модулей нейросетей
- Детальное понимание рабочего процесса (workflow) в ComfyUI. Узлы ComfyUI
- Настройки workflow при генерации изображений, видео, музыки и 3D моделей в ComfyUI
- Улучшение качества изображений и видео с помощью перехода на модели полной точности (неквантованные модели)
- Уменьшение потребления VRAM и ускорение вычислений за счёт перехода на квантованные модели
- Модификация workflow для использования дообученных моделей в ComfyUI
- Создание новых workflow в ComfyUI с нуля
- Как использовать модели в формате GGUF в ComfyUI
- Как делать апскейлинг (upscale) изображений и видео с помощью ИИ
- Опции и настройки для экономии видеопамяти (VRAM). Как создавать HD видео на обычном компьютере
- Есть ли цензура в локальных ИИ. Почему результаты не соответствуют запросам. Глубокое понимание работы нейросетей. Как полностью снять все запреты с локальных ИИ
- Коммерческие ИИ (нейросети) для создания и редактирования картинок, видео, 3D, озвучивания текста и прочего (краткое описание готовых шаблонов ComfyUI доступных по API)
- Обзор популярных кастомных моделей
- Обзор популярных дообученных модулей (LoRA-адаптеров)
- Обзор ИИ-моделей для генерации аниме-артов
- Обзор дообученных модулей (LoRA-адаптеров) для аниме-изображений
- Генерация изображений в аниме-стиле с помощью нейросетей
……………..
……………..
И это далеко не конец!!! Проявляете активность: пишите в комментариях ваши замечания по найденным ошибкам, делитесь ссылками на эту онлайн книгу. При возможности, вы можете донатить для оплаты железа используемого в тестировании. При наличии интереса и активности, данная книга будет быстро дополняться новыми главами — здесь ещё много интересных тем, от детальной настройки стиля генерируемого контента до самостоятельного дообучения моделей.
ИИ моделей для генерации изображений много. И нельзя какую-то одну из них выделить как «лучшая». Дело в том, что под разные задачи лучшей может оказаться та или иная модель: кто-то гонится за предельным реализмом, а для кого-то лучшая модель та, которая лучше всех рисует Губка Боба в форме печенья Орео…
Кроме того, получаемый результат зависит от настроек и дополнительных модулей. Чтобы выбрать лучшую для себя модель рекомендуется попробовать их под ваши промпты.
Также модели значительно различаются требованиями к ресурсам — вы можете выбрать для себя более лёгкие и быстрые модели, если у вас не очень мощный компьютер.
Используемый порядок сортировки: в этой главе модели внутри подразделов отсортированы от самой новой к более старым. Если вас интересует, какие модели являются лучшими, то в последующих разделах используется именно такая сортировка — первыми идут наиболее предпочитаемые модели, в конце собраны модели которые дают худший результат или устарели. Такая сортировка начинается с главы «Основы генерации изображений из текстовых запросов на своём компьютере». То есть обратитесь к этой главе чтобы выбрать лучшие модели для генерации картинок из текстовых запросов — далее аналогично в последующих главах. В этой же главе собран полный каталог моделей, начиная с самых новых.
ПРИМЕЧАНИЕ: больше образцов картинок и видео для каждой модели будут добавлены чуть позже.
4.1 Текст в изображение (T2I)
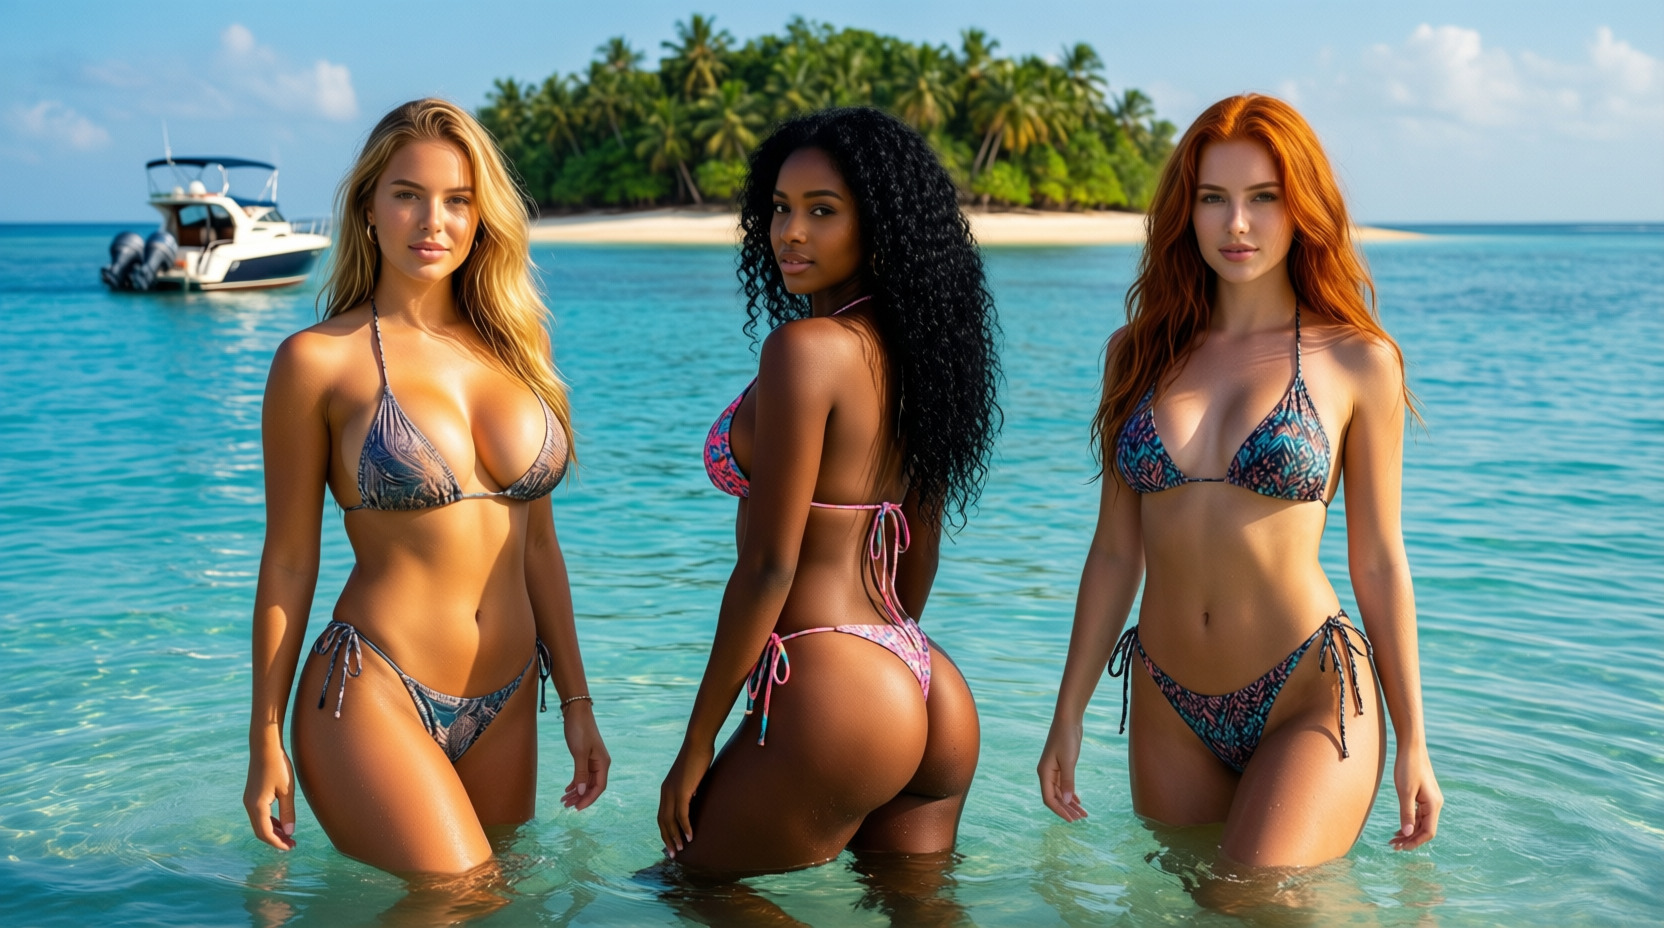
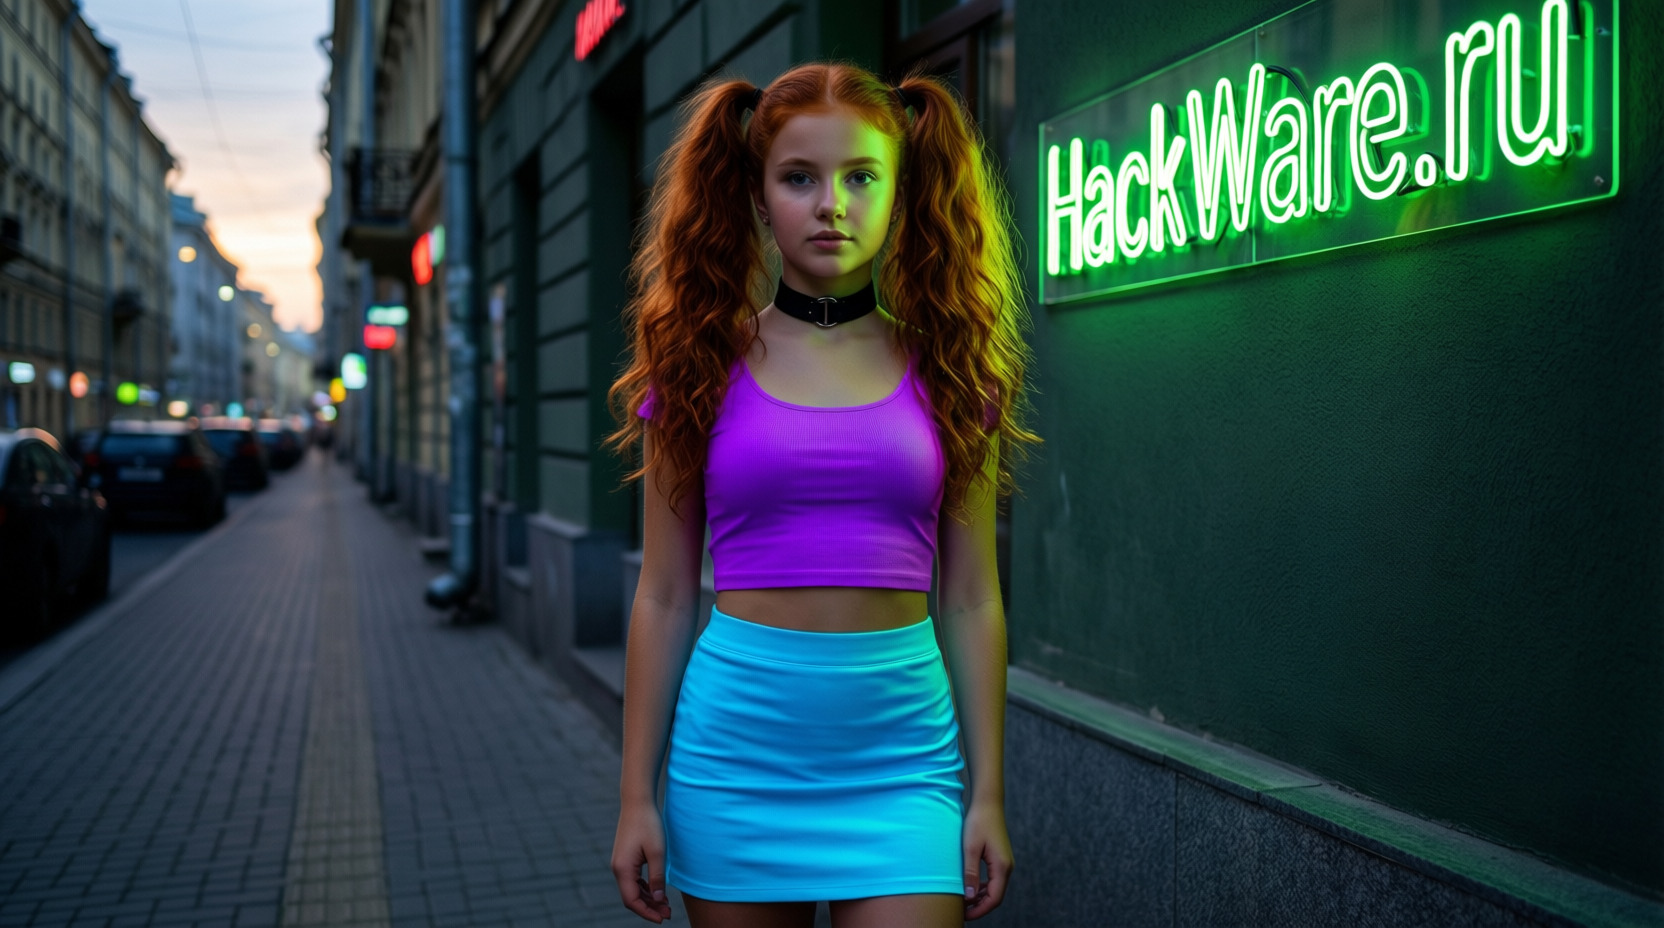
Qwen-Image-2512
Обновление модели Qwen-Image несущее большое количество изменений.
Примеры картинок созданных в Qwen-Image-2512:
Ovis-Image Text to Image
Ovis-Image – это модель текст-в-изображение с размером 7B, специально оптимизированная для высокого качества отображения текста на сгенерированных изображениях. Разработанная для эффективной работы при ограниченных вычислительных ресурсах, она превосходно справляется с точным созданием изображений с текстовым содержанием.
По сути, это сильно упрощённая версия Qwen — изображения Ovis-Image в целом очень похожи на картинки генерируемые Qwen, но при этом содержат больше ошибок и недоработанностей.
Примеры картинок созданных в Ovis-Image Text to Image:


Размер: 20,3 гигабайт.
Z-Image-Turbo Text to Image
Эффективная фундаментальная модель генерации изображений с однопотоковым диффузионным преобразователем, поддерживает английский и китайский языки.
Создаёт изображения очень быстро, качество изображений весьма высокое с точки зрения реализма. Хорошо отрисовывает текст на изображениях.
Примеры картинок созданных в Z-Image-Turbo Text to Image:


Размер: 35,4 гигабайт.
Flux.2 Dev
Flux.2 Dev (также названия пишут как FLUX.2 [dev]) создаёт фотореалистичные изображения с разрешением до 4 МП.
Это новая версия Flux Dev, она лучше понимает промпты, делает изображения великолепного качества и хорошо рендерит текст на изображениях. Эта версия является универсальной и может как создавать изображения из текстовых запросов, так и редактировать изображения.
Примеры картинок созданных в Flux.2 Dev:


Размер: 53,9 гигабайт.
Flux Dev full text to image
Создаёт высококачественные изображения с помощью полной версии Flux Dev. Требуется больший объем видеопамяти и несколько файлов моделей, но это обеспечивает наилучшее соответствие запросу и высочайшее качество изображений.
Flux это одна из лучших (если не лучшая) в плане создания реалистичных изображений модель. А Flux Dev full это самая топовая из разновидностей Flux.
Размер: 34,2 гигабайта.
Примеры картинок сделанных в Flux Dev full:


Flux Schnell full text to image
Быстро создаёт изображения с помощью полной версии Flux Schnell. Для создания изображений требуется всего 4 шага, при этом сохраняется высокое качество изображения.
То есть эта та же самая полная версия Flux, но с оптимизациями которые значительно сокращают время создания изображения практически без потери качества.
Размер: 34,2 гигабайта.
Flux Dev fp8
Генерация изображений с использованием квантованной версии Flux Dev fp8. Подходит для устройств с ограниченным объёмом видеопамяти, требует только один файл модели, но качество изображений немного ниже, чем у полной версии.
То есть это оптимизированная по размеру версия, которая генерирует изображение в достаточно большое количество шагов (это требует времени).
Качество выдаваемых изображений хорошее.
Размер: 17,2 гигабайта.
Flux Schnell fp8
Быстро создаёт изображения с помощью квантованной версии Flux Schnell fp8. Идеально подходит для маломощного оборудования, для генерации изображений требуется всего 4 шага.
То есть эта модель и с оптимизацией размера самой модели, и с ускоренным процессом создания картинок. При всём при этом, модель может выдавать картинки отличного качества.
Это вариант для самого слабого железа.
Размер: 17,2 гигабайта.
Flux.1 Krea Dev
Тонко настроенная модель FLUX, выжимающая максимум фотореализма.
Отличная модель, зачастую показывает себя даже лучше Flux Dev full.
Размер: 22,3 гигабайта.
Примеры картинок сделанных в Flux.1 Krea Dev:


Chroma text to image (Chroma1-HD)
Chroma модель на той же архитектуре как и Flux. Chroma описывается как «улучшенная модель Flux с повышенным качеством изображения и лучшим пониманием текстовых запросов для создания потрясающих изображений на основе текста».
На практике Chroma выдаёт крайне нестабильные результаты.
Размер: 23,3 гигабайта.
Пример картинок сделанных в Chroma text to image:


Wan 2.2 text-to-image
Wan — это модель которая в первую очередь предназначена для создания видео — и в этом она действительно хороша.
Но поскольку Wan может делать отлично согласованные по внутренним деталям кадры которые выглядят очень реалистично, то Wan также можно использовать и для создания изображений (для этого длину «видео» устанавливают на 1 кадр).
Пример картинок сделанной в Wan 2.2:


HiDream I1 Full
Создаёт изображения с помощью HiDream I1 Full – полной версии с 50 шагами генерации для получения максимально качественного результата.
В целом HiDream I1 выдаёт картинки весьма хорошего качества — это один из лидеров.
Размер: 24,3 гигабайта.
Пример картинок сделанных в HiDream I1 Full:


HiDream I1 Dev
Создаёт изображения с помощью HiDream I1 Dev — сбалансированная версия с 28 шагами вывода, подходящая для оборудования средней производительности.
То есть эта модель будет потреблять столько же памяти, но будет работать быстрее за счёт меньшего количества шагов.
Судя по отзывам, разница между HiDream I1 Full и HiDream I1 Dev невелика. Кому-то изображения из HiDream I1 Dev нравятся даже больше.
Размер: 33,4 гигабайта (это данные из документации, видимо, в них ошибка, реальный размер такой же как у HiDream I1 Full, то есть 24,3 гигабайта).
HiDream I1 Fast
Быстро создаёт изображения с помощью HiDream I1 Fast — облегчённой версии с 16 шагами вывода, идеально подходящей для быстрого предварительного просмотра на менее мощном оборудовании.
Размер: 24,3 гигабайта.
Chroma1 Radiance text to image
Chroma1-Radiance работает напрямую с пикселями изображения, а не со сжатыми латентными сигналами, обеспечивая более высокое качество изображений с меньшим количеством артефактов и искажений.
Может создавать впечатляющие изображения, но часто выдаёт бессмыслицу. Иногда выдаёт хорошие изображения с неправильными деталями — это легко исправляется в редакторах на основе нейросетей.
Возможно, эта модель требует особого подхода к написанию промптов — это может исправить проблему плохих изображений.
Размер: 23,7 гигабайта.
Примеры картинок сделанных в Chroma1 Radiance:


OmniGen2
Создаёт высококачественные изображения из текстовых подсказок, используя унифицированную многомодальную модель 7B OmniGen2 с двухпутевой архитектурой.
В моих тестах получалось много дефектных изображений — возможно, эта модель требует особого подхода к написанию промптов.
Размер: 15,8 гигабайта.
Примеры картинок созданных в OmniGen2:


Qwen-Image Text to Image
Генерация изображений на основе текстовых запросов с использованием модели Qwen-Image.
Qwen Image — это диффузионная модель с 20 миллиардами параметров (чем больше — тем лучше, но и требования к видеопамяти также растут).
По беглым впечатления, весьма хороша, при одинаковых запросах может выдавать людей с одинаковыми лицами. Причём даже с одинаковым наклоном головы. Причём не помогает даже явное указание в негативном промпте «Asian».
Размер: 31,8 гигабайта.
Пример картинок сделанных в Qwen Image:


SDXL Simple
Создаёт высококачественные изображения с помощью SDXL.
SDXL — это новое поколение от тех людей, которые сделали в своё время Stable Diffusion. В отличии от Stable Diffusion 1.5, SDXL считается новым поколением с другой архитектурой.
На мой субъективный взгляд, и у SDXL и у SD1.5 один большой недостаток — по этим изображениям видно, что они сгенерированы нейросетью. Честно говоря, от этих изображений немного уже тошнит: какие-то легко уловимые одинаковости в текстуре кожи, в позах, в том как выглядят волосы, в ошибках на картинках.
И тем не менее, с SDXL всё равно можно получить неплохие картинки. Также к этим моделям имеется множество дообученных модулей, что вполне позволяет творить настоящие шедевры, не похожие на дефолтные картинки Stable Diffusion. Но всем этим нужно уметь польоваться.
Размер: 13,1 гигабайта.
SDXL Refiner Prompt
Улучшение изображений SDXL с помощью моделей уточнения.
Размер: 13,1 гигабайта.
SDXL Turbo
Создаёт изображения за один шаг с помощью SDXL Turbo.
Быстрая и лёгкая.
Размер: 7 гигабайта.
SD3.5 Simple
Генерирует изображения с помощью SD 3.5.
Это та самая Stable Diffusion. Может создавать хорошие картинки. Имеет много модулей. Но без модулей, на мой вкус, немного замылила глаз.
Размер: 15 гигабайт.
Пример картинки сделанной в SD3.5:

SD3.5 (pruned, emaonly)
Можно найти в галерее шаблонов по запросам «Image Generation» или «Generate images from text prompts».
Очень маленький вариант SD3.5 — 2.2 гигабайта.
SD3.5 Gligen Textbox / Area Composition / Area Composition Square Area for Subject
- Gligen Textbox (Создаёт изображения с точным размещением объектов с помощью текстовых полей)
- Area Composition (Создаёт изображения, управляя композицией с помощью заданных областей)
- Area Composition Square Area for Subject (Создаёт изображения, управляя композицией с помощью заданных областей)
Все они размером от 2.5 до 3 гигабайт.
NetaYume Lumina Text to Image
Генерация высококачественных изображений в стиле аниме с улучшенным пониманием персонажей и детализированными текстурами. Точная настройка от Neta Lumina на основе датасета Danbooru.
Размер: 10,7 гигабайта.
DreamShaper
DreamShaper — это серия моделей, которые развивают оригинальную SD, начиная с версии 1.5, а затем — SDXL.
В галерее шаблонов можно найти DreamShaper по следующим названиям:
- Upscale (Улучшение качества изображений путём повышения разрешения в латентном пространстве)
- ESRGAN (Улучшение качества изображений с помощью моделей ESRGAN)
- HiresFix ESRGAN Workflow (Масштабирование изображений с использованием моделей ESRGAN на промежуточных этапах генерации)
- Latent Upscale Different Prompt Model (Улучшение качества изображений с одновременным изменением текстовых подсказок на разных этапах генерации)
У всех у них маленькие размеры от 2.2 гигабайт до 4.2 гигабайт.
4.2 Изображение в изображение (I2I)
Illustration to Realism
Введите нарисованного персонажа (иллюстрацию) и создайте ультрареалистичную версию с помощью Qwen Image Edit 2509.
Relight Composited Product
Загрузите скомпилированное изображение вашего продукта, нарисуйте маску в редакторе масок и измените освещение вашего продукта в сцене.
Image Relight
Изменение освещения изображений с помощью Qwen-Image-Edit с поддержкой LoRA.
Размер: 32,8 гигабайт.
1 click Multiple Scene Angles
Загрузите изображение вашей сцены и сгенерируйте несколько видов вашей сцены всего одним кликом.
Размер: 31,2 гигабайт.
1 Click Multiple Character Angles
Загрузите изображение вашего персонажа и получите несколько видов этого изображения с разных ракурсов.
Размер: 31,2 гигабайт.
Z-Image-Turbo Fun Union ControlNet
Мультиконтрольный ControlNet с поддержкой Canny, HED, Depth, Pose и MLSD для Z-Image-Turbo.
Размер: 23,8 гигабайт.
Flux.2 Dev
Flux.2 Dev (также называют FLUX.2 [dev] уже упоминалась в разделе T2I), это весьма мощная нейросеть, при этом кроме создания фотографий из текстовых запросов, Flux.2 Dev может создавать изображения из рефересных (можно указывать до 10 картинок), а также редактировать изображения.
Размер: 53,9 гигабайт.
Product Mockup (Flux.2 Dev FP8)
Создаёт макеты продуктов, применяя шаблоны дизайна к упаковке, кружкам и другим продуктам, используя многоэтапную согласованность.
Размер: 53,9 гигабайт.
Flux.1 Dev OneReward
Поддерживает различные задачи, такие как дорисовка и перерисовка изображений, а также удаление объектов.
Размер: 29 гигабайт.
Flux.1 Dev USO Reference Image Generation
Используйте референсные изображения для управления стилем и темой — сохраняйте лицо персонажа, изменяя художественный стиль, или применяет художественные стили к новым сценам.
Размер: 18,6 гигабайт.
Flux Kontext Dev Image Edit
Интеллектуальное редактирование изображений, которое обеспечивает единообразие персонажей, редактирует определённые части, не затрагивая другие, и сохраняет оригинальные стили.
Размер: 17,6 гигабайт.
Flux Inpaint
Заполняет недостающие части изображений с помощью Flux inpainting.
Размер: 10,4 гигабайт.
Flux Outpaint
Расширяет изображения за пределы границ с помощью Flux Outpainting.
Размер: 10,4 гигабайт.
Flux Canny Model
Создаёт изображения, руководствуясь обнаружением границ с помощью Flux Canny.
Размер: 34,2 гигабайт.
Flux Depth Lora
Создаёт изображения на основе информации о глубине с помощью Flux LoRA.
Размер: 35,5 гигабайт.
Flux Redux Model
Создаёт изображения, перенося стиль из референсных изображений с помощью Flux Redux.
Размер: 35,2 гигабайт.
HiDream E1.1 Image Edit
Редактирует изображения с помощью HiDream E1.1 — по качеству изображения и точности редактирования он лучше, чем HiDream-E1-Full.
Размер: 50,5 гигабайт.
HiDream E1 Image Edit
Редактирует изображения с помощью HiDream E1 — профессиональной модели редактирования изображений на естественном языке.
Размер: 34,2 гигабайт.
Qwen Image Editing (New)
Редактируйте изображения с помощью Qwen-Image-Edit, новейшей модели OSS.
Размер: 31,8 гигабайт.
Qwen Image Edit 2509
Расширенное редактирование изображений с поддержкой нескольких изображений, улучшенной согласованностью и интеграцией ControlNet.
Размер: 31,8 гигабайт.
Qwen Image Edit
Редактирует изображения с точным двуязычным (китайский и английский) редактированием текста и двойным управлением смыслом и внешним видом с помощью модели Qwen-Image-Edit 20B MMDiT.
Размер: 31,8 гигабайт.
Qwen-Image InstantX Union ControlNet
Создаёт изображения с помощью Qwen-Image InstantX ControlNet, поддерживая canny, soft edge, depth, pose.
Размер: 35,4 гигабайт.
Qwen-Image InstantX Inpainting ControlNet
Профессиональные inpainting и редактирование изображений с помощью Qwen-Image InstantX ControlNet и Qwen Image InstantX ControlNet Inpainting. Поддерживает замену объектов, изменение текста, изменение фона и outpainting.
Размер: 36,1 гигабайт.
Qwen-Image Union Control
Создаёт изображения с точным структурным контролем с помощью унифицированной платформы ControlNet LoRA от Qwen-Image. Поддерживает различные типы управления, включая Canny, Depth, Lineart, Softedge, Normal и OpenPose, для разнообразных творческих задач.
Размер: 32,8 гигабайт.
Qwen-Image ControlNet model patch
Управляйте генерацией изображений с помощью моделей Qwen-Image ControlNet. Поддерживаются режимы canny, depth и inpainting через механизм патчинга модели.
Размер: 34 гигабайт.
ChronoEdit 14B
Редактирование изображений на основе динамического понимания видеомоделей позволяет создавать физически правдоподобные результаты, сохраняя при этом единообразие характера и стиля.
Смысл её в том, чтобы редактировать изображения максимально «физически правдоподобно», как если бы изменения происходили в реальном мире.
Основана на видеомодели (Wan2.1-I2V-14B) и изменяет кадр так, как будто бы произошло реальное физическое событие. То есть так же как Wan рисует свои видео. Времени и ресурсов занимает примерно столько же сколько нужно для создания видео.
Размер: 40,5 гигабайт.
OmniGen2 Image Edit
Редактирует изображения с инструкциями на естественном языке, используя расширенные возможности редактирования изображений OmniGen2 и поддержку рендеринга текста.
Размер: 15,8 гигабайт.
SDXL Revision Text Prompts
Создаёт изображения, перенося концепции из эталонных изображений с помощью SDXL Revision.
Размер: 10,7 гигабайт.
SD1.5 Image to Image
Трансформирует существующие изображения, используя текстовые подсказки.
Размер: 2,2 гигабайт.
SD1.5 Inpaint
Легко редактируйте отдельные части изображений.
Размер: 5,2 гигабайт.
SD1.5 Outpaint
Расширяет изображения за пределы их исходных границ.
Размер: 5,2 гигабайт.
SD1.5 Embedding
Создаёт изображения, используя текстовую инверсию для обеспечения единообразия стилей.
Размер: 5,2 гигабайт.
SD3.5 Large Canny ControlNet
Генерация изображений на основе обнаружения контуров с использованием SD 3.5 Canny ControlNet.
Размер: 23,6 гигабайт.
SD3.5 Large Depth
Создаёт изображения с помощью SD 3.5 на основе информации о глубине.
Размер: 23,6 гигабайт.
SD3.5 Large Blur
Создаёт изображения на основе размытых референтных изображений с помощью SD 3.5.
Размер: 23,6 гигабайт.
SD1.5 Scribble ControlNet
Создаёт изображения на основе эталонных изображений с помощью ControlNet.
Размер: 3,2 гигабайт.
SD1.5 Pose ControlNet 2 Pass
Создаёт изображения на основе позовых эталонов с помощью ControlNet.
Размер: 4,7 гигабайт.
SD1.5 Depth ControlNet
Генерация изображений на основе информации о глубине с помощью ControlNet.
Размер: 2,9 гигабайт.
SD1.5 Depth T2I Adapter
Генерация изображений на основе информации о глубине с помощью адаптера T2I.
Размер: 2,5 гигабайт.
SD1.5 Mixing ControlNets
Создаёт изображения, комбинируя несколько моделей ControlNet.
Размер: 3,3 гигабайт.
4.3 Текст в видео (T2V)
Kandinsky 5.0 Video Lite Text to Video
Лёгкая модель 2B, которая генерирует видео из картинок по английским и русским запросам с высоким качеством изображения.
Размер: 14,8 гигабайт.
Wan 2.2 14B Text to Video
Создаёт высококачественные видеоролики из текстовых подсказок с кинематографическим эстетическим контролем и генерацией динамического движения с помощью Wan 2.2.
Очень качественный ИИ для создания крайней реалистичных видео.
Имеет быстрый и обычный режимы.
Ролики с разрешением 1280×1280 выглядят просто великолепно.
Можно генерировать только 1 кадр — и использовать для генерации картинок. В плане генерации картинок в плане реалистичности может создавать конкуренцию самым сильным ИИ.
Размер: 38,1 гигабайт.
Примеры видео сделанные в Wan 2.2 14B Text to Video:
Hunyuan Video 1.5 Text to Video
Создаёт высококачественные видео 720p из текстовых подсказок с кинематографическим управлением камерой, эмоциональными выражениями и симуляцией физики. Поддерживает различные стили, включая реалистичный, аниме и 3D с рендерингом текста.
Может делать апскейл видео до 1080p с добавлением новых деталей.
Пример видео созданных в Hunyuan Video 1.5 Text to Video:
Размер: 45,4 гигабайта.
Wan 2.2 5B Video Generation
Быстрая генерация текста в видео и изображений в видео с параметрами 5B. Оптимизировано для быстрого создания прототипов и творческих экспериментов.
Эта модель тренировалась на HD материалах и может создавать HD контент. Но поскольку она использует 5 миллиардов параметров (вместо 14 миллиардов у Wan 2.2 14B), то она заметно поглупее.
При меньших разрешениях кадров (не HD) может рассматриваться как более лёгкая альтернатива Wan 2.2 14B.
На мой взгляд, Wan 2.2 14B на голову лучше этой нейросети.
Размер: 18,2 гигабайт.
Hunyuan Video: Text to Video
Генерация видеороликов из текстовых подсказок с использованием модели Хуньюань.
Может генерировать крайне реалистичные HD ролики. Но капризна в плане промптов — на некоторые промпты может выдавать бессмыслицу.
Это сильный конкурент для Wan 2.2 14B в плане генерации видео по текстовым запросам.
Размер: 35,5 гигабайт.
Примеры видео сделанных в Hunyuan Video:
Mochi Text to Video
Генерация видеороликов из текстовых подсказок с использованием модели Mochi.
Размер: 30,8 гигабайт.
LTXV Text to Video
Создаёт видеоролики из текстовых подсказок.
Размер: 19,2 гигабайт.
SVD Text to Image to Video
Создаёт видеоролики, предварительно создавая изображения из текстовых подсказок.
Размер: 16,5 гигабайт.
Wan2.1 VACE Text to Video
Преобразует текстовые описания в высококачественные видео. Поддерживает разрешение 480p и 720p с моделью VACE-14B.
Размер: 57,8 гигабайт.
Wan2.1 Alpha T2V
Генерация текста в видео с поддержкой альфа-канала для прозрачных фонов и полупрозрачных объектов.
Размер: 22,5 гигабайт.
Wan 2.1 Text to Video
Генерация видео из текстовых подсказок с помощью Wan 2.1
Размер: 9,9 гигабайт.
4.4 Изображение в видео (I2V)
Animation Trajectory Control (Wan2.1, ATI)
Нарисуйте траекторию движения, которую вы хотите для исходного изображения.
Размер: 31,7 гигабайт.
Wan-Move Motion-Control Image to Video (Wan2.1)
Создаёт видео из одного изображения с помощью Wan-Move, используя детализированное управление движением на уровне точек через направляющие траектории.
Размер: 25,5 гигабайт.
Kandinsky 5.0 Video Lite Image to Video
Лёгкая модель 2B, которая генерирует видео по английским и русским запросам с высоким качеством изображения.
Размер: 14,8 гигабайт.
Wan 2.2 14B Image to Video
Преобразует статичные изображения в динамичные видеоролики с точным управлением движением и сохранением стиля с помощью Wan 2.2.
Размер: 38,1 гигабайт.
Пример видео сделанного в Wan 2.2 14B Image to Video:
Hunyuan Video 1.5 Image to Video
Превращает неподвижные изображения в динамичные видеоролики с точным управлением движением и камерой. Сохраняет визуальную целостность, оживляя фотографии и иллюстрации плавными, естественными движениями.
Размер: 45,4 гигабайта.
Wan 2.2 14B Fun Inp
Создаёт видео из начальных и конечных кадров с помощью Wan 2.2 Fun Inp.
Размер: 38,1 гигабайт.
Wan 2.2 14B Fun Camera Control
Создаёт видеоролики с помощью управления движением камеры, включая панорамирование, масштабирование и вращение, с помощью Wan 2.2 Fun Camera Control.
Размер: 40,1 гигабайт.
Wan 2.2 5B Fun Inpaint
Эффективная прорисовка видео с начальных и конечных кадров. Модель 5B обеспечивает быстрые итерации для тестирования рабочих процессов.
Размер: 18,2 гигабайт.
Wan 2.1 Image to Video
Генерация видео из изображений с помощью Wan 2.1.
Размер: 41,1 гигабайт.
Wan2.1 VACE Reference to Video
Создаёт видео, соответствующие стилю и содержанию исходного изображения. Идеально подходит для создания видео в едином стиле.
Размер: 57,8 гигабайт.
Wan2.1 ATI
Генерация видео с управлением траекторией.
Размер: 25,4 гигабайт.
Wan 2.1 Fun Camera 14B
Создаёт высококачественные видео с расширенным управлением камерой, используя полную модель 14B
Размер: 42,1 гигабайт.
Wan 2.1 Fun Camera 1.3B
Создаёт динамичные видеоролики с кинематографическими движениями камеры, используя модель Wan 2.1 Fun Camera 1.3B.
Размер: 11,5 гигабайт.
Hunyuan Video: Image to Video
Генерация видео из изображения в HD с использованием Hunyuan Video.
Размер: 37,5 гигабайт.
LTXV Image to Video
Создаёт видеоролики из неподвижных изображений.
Размер: 19,2 гигабайт.
SVD Image to Video
Создаёт видеоролики из неподвижных изображений.
Размер: 10 гигабайт.
4.5 Первый и последний кадр в видео (FLF2V)
Multi-Keyframe Video Stitching (Wan2.2, FLF2V)
Создаёт плавное видео с использованием 6 ключевых кадров. Автоматически заполняет движение между кадрами и бесшовно соединяет сегменты.
Wan 2.2 14B First-Last Frame to Video
Создаёт плавные видеопереходы, определяя начальные и конечные кадры.
То есть если дать ИИ две фотографии, на одной из которых человек в очках, а на другой без очков, то ИИ сделает видео как человек снимает очки.
Размер: 38,1 гигабайт.
Wan2.1 VACE First-Last Frame
Создаёт видео фрагмент на основе первого и конечного кадров. Поддерживает пользовательские последовательности ключевых кадров.
Размер: 57,8 гигабайт.
Wan 2.1 FLF2V 720p F16
Создаёт видео фрагмент на основе первого и конечного кадров. Поддерживает пользовательские последовательности видео, управляя первым и последним кадрами с помощью Wan 2.1 FLF2V.
Размер: 41,1 гигабайт.
Wan 2.1 Inpainting
Создаёт видео из начальных и конечных кадров с помощью Wan 2.1 inpainting.
Размер: 11,4 гигабайт.
4.6 Видео в видео (V2V)
Wan 2.2 14B Fun Control
Создаёт видеоролики, используя элементы управления позой, глубиной и краями с помощью Wan 2.2 Fun Control.
Размер: 38,1 гигабайт.
Wan2.2 Animate, character animation and replacement
Унифицированная система анимации и замены персонажей с точным воспроизведением движений и мимики.
Размер: 27,5 гигабайт.
Wan 2.2 5B Fun Control
Многорежимное видеоуправление с наведением позы, глубины и краёв. Компактный размер 5B для экспериментальной разработки.
Размер: 18,15 гигабайт.
Wan2.1 VACE Control Video
Создаёт видео, управляя входными видео и эталонными изображениями с помощью Wan VACE.
Размер: 57,8 гигабайт.
Wan2.1 VACE Outpainting
Создаёт расширенные видео, увеличивая размер видео кадра с помощью технологии Wan VACE Outpainting.
Размер: 57,8 гигабайт.
Wan2.1 VACE Inpainting
Реактирует отдельные области видео, сохраняя окружающий контент. Отлично подходит для удаления или замены объектов.
Размер: 57,8 гигабайт.
Wan 2.1 ControlNet
Создаёт видеоролики, используя элементы управления позой, глубиной и краями с помощью Wan 2.1 ControlNet.
Размер: 11,4 гигабайт.
4.7 Речь/звук в видео (S2V)
Wan2.2-S2V Audio-Driven Video Generation
Преобразует статичные изображения и аудио в динамичные видеоролики с идеальной синхронизацией и генерацией на уровне минут.
Размер: 25,3 гигабайт.
HuMo Video Generation
Создаёт видеоролики, состоящие из звука, изображения и текста, обеспечивает синхронизацию губ персонажей.
Размер: 27,9 гигабайт.
4.8 Текст в аудио (T2A)
Stable Audio
Создаёт звук (музыку) из текстовых подсказок с помощью Stable Audio.
Размер: 5,8 гигабайт.
ACE Step v1 Text to Song
Создаёт песни с вокалом из текстовых подсказок с помощью ACE-Step v1, поддерживающего многоязычность и настройку стилей.
Размер: 7,7 гигабайт.
ACE-Step v1 Text to Instrumentals Music
Создаёт инструментальную музыку по текстовым подсказкам с помощью ACE-Step v1.
Размер: 7,7 гигабайт.
4.9 Музыка в музыку (M2M)
ACE Step v1 M2M Editing
Редактирует существующие песни, изменяя стиль и тексты с помощью ACE-Step v1 M2M.
Размер: 7,7 гигабайт.
4.10 Изображение в 3D модель (I2M)
Hunyuan3D 2.1
Создаёт 3D-модели из отдельных изображений с помощью Hunyuan3D 2.1.
Размер: 5 гигабайт.
Hunyuan3D 2.0
Создаёт 3D-модели из отдельных изображений с помощью Hunyuan3D 2.0.
Размер: 5 гигабайт.
4.11 Несколько изображений в 3D модель (MV2M)
Hunyuan3D 2.0 MV
Создаёт 3D-модели из нескольких видов (изображений) с помощью Hunyuan3D 2.0 MV.
Размер: 5 гигабайт.
Hunyuan3D 2.0 MV Turbo
Создаёт 3D-модели из нескольких видов с помощью Hunyuan3D 2.0 MV Turbo.
Размер: 5 гигабайт.
Смотрите продолжение: Знакомство с ComfyUI
Связанные статьи:
- 6. Основы генерации изображений из текстовых запросов на своём компьютере (100%)
- 7. Расширение области видимости изображений с помощью нейросетей: расширение кадра, изменение соотношения сторон с добавлением новой информации (outpainting) (56.9%)
- 9. Редактирование изображения с помощью нейросетей (I2I) (56.9%)
- 10. Междоменный перевод изображений (преобразование между различными типами изображений) (56.9%)
- Как запустить ComfyUI на Android: подробная инструкция и подбор моделей ИИ для генерации изображений на мобильном телефоне (56.1%)
- 11. Превращение нефотографических изображений в фотографии (фотореалистичные изображения) с помощью ИИ (RANDOM - 54.4%)