Распознавание рукописного и печатного текста, формул и таблиц локальным ИИ: OCR нейросетью на своём компьютере (инструкция по использованию HunyuanOCR-1.5)
Оглавление
1. Программа для OCR с помощью ИИ на своём компьютере
2. Как на своём компьютере запустить HunyuanOCR-1.5 с графическим интерфейсом
3. Где скачать локальный ИИ для перевода на своём компьютере
4. Установка HunyuanOCR-1.5 с графическим интерфейсом
4.1 Как установить HunyuanOCR-1.5 на Linux и Windows
4.2 Как установить HunyuanOCR-1.5 на мобильном телефоне Android
7. Ускорение инференса HunyuanOCR-1.5 с помощью DFlash
8. Настройки сервера MiAl AI OCR (HunyuanOCR-1.5). Выбор модели и бэкэнда
1. Программа для OCR с помощью ИИ на своём компьютере
HunyuanOCR-1.5 — это лёгкая сквозная (end-to-end) визуально-языковая модель, специализированная на задачах OCR. Она предназначена для широкого спектра задач, связанных с визуальным распознаванием и обработкой текста, и объединяет в рамках одной сквозной VLM разбор документов, обнаружение текста (text spotting), извлечение информации и перевод текста с изображений (text-image translation).
Следует отметить такие особенности модели как:
- великолепное понимание формул
- великолепное понимание рукописного текста на английском и некоторых других языках
- модель достаточно лёгкая чтобы работать на мобильном телефоне с приемлемой скоростью
Для разработчиков и тех кого интересует работа локальных ИИ «под капотом» будет интересно отметить, что HunyuanOCR-1.5 это мультимодальная модель — загрузка модели и подготовка данных перед обработкой отличается от одномодальных моделей.
И ещё HunyuanOCR-1.5 поддерживает спекулятивное декодирование с использованием черновой модели. С практической точки зрения это важно поскольку это может неплохо ускорить работу модели. А с теоретической точки зрения это интересно как можно добиться ускорения инференса без потери качества: главная модель действует в паре со своей черновой версией, но всё это вместе работает быстрее, чем если бы действовала только одна главная модель. Мы поговорим об этом подробнее ниже, также мы разберёмся, почему ускорение не такое драматическое как можно было бы ожидать исходя из описания этой технологии и почему конкретный выигрыш времени носит вероятностный характер.
2. Как на своём компьютере запустить HunyuanOCR-1.5 с графическим интерфейсом
В этой инструкции используются модели ИИ созданы командой Tencent, но в дополнении к ним написан серверный и клиентский код (это вклад автора HackWare.ru), который упрощает развёртывание и удобство использования этими нейросетями.
Особенности и возможности MiAl AI OCR (HunyuanOCR-1.5):
- открытый серверный и клиентский код для удобного запуска и использования HunyuanOCR-1.5 на своём компьютере
- графический интерфейс для работы с HunyuanOCR-1.5
- работа с PDF, а также с файлами изображений в любом формате включая HEIC (популярный на телефонах)
- оптимизация для работы на мобильных телефонах
- 3 бэкэнда на выбор: GGUF, vLLM, Transformers
- обработка любого количества страниц и файлов без OOM (сервер автоматически балансирует нагрузку)
- обработка пачками (батчами) страниц и файлов для ускорения работы
- удобный выбор сжатия размера изображения
- поддержка черновой модели (включая автоматизированный процесс скачивания и конвертации драфтовой модели)
- удобный выбор промпта определяющего характер задачи для выполнения
- сохранение распознанных страниц в популярных текстовых и офисных форматах (Markdown, HTML + MathJax/KaTeX, ODT, DOCX, EPUB, LaTeX, PDF)
- всё бесплатно, без ограничений, работает исключительно на вашем компьютере
3. Где скачать локальный ИИ для перевода на своём компьютере
- https://huggingface.co/tencent/HunyuanOCR: официальный сайт HunyuanOCR-1.5:
- https://huggingface.co/ggml-org/HunyuanOCR-GGUF: репозиторий с GGUF версиями, всего 2 варианта квантования
- https://huggingface.co/prithivMLmods/HunyuanOCR-1.5-GGUF-Updated: репозиторий с GGUF версиями, много вариантов квантования
И на самом деле ничего из этого вам скачивать не нужно, потому что модели будут скачены автоматически, а другое оригинальное ПО вам будут даны немного ниже.
4. Установка HunyuanOCR-1.5 с графическим интерфейсом
4.1 Как установить HunyuanOCR-1.5 на Linux и Windows
Запуск моделей и сопутствующего программного обеспечения успешно протестирован в Linux и Windows — вы можете использовать любую из этих операционных систем. Начните с этих статей:
- Как настроить Windows для запуска любых нейросетей (ИИ) на своём компьютере
- Подготовка Linux для локального запуска нейросетей (ИИ)
Если вы пользователь Windows, то запустите WSL:
wsl
Дальше процесс установки идентичный на обоих этих операционных системах.
mkdir -p ~/ai/HunyuanOCR
cd ~/ai/HunyuanOCR
python -m venv venv
source venv/bin/activate
pip install vllm transformers accelerate pillow-heif Pillow PyMuPDF
Установка следующего пакета занимает много времени — будьте к этому готовы, оно не зависло, оно реально столько работает. Этот пакет является опциональным и вы можете пропустить его установку, но в моих тестах я всегда его устанавливал. Установка этого пакета имеет смысл только на устройствах с NVIDIA GPU или AMD GPU, на устройствах с только CPU устанавливать его не нужно:
pip install --no-build-isolation --no-cache-dir flash-attn
Если предыдущая команда вылетает из-за нехватки оперативной памяти, то уменьшите количество потоков с помощью переменной MAX_JOBS:
MAX_JOBS=6 pip install --no-build-isolation --no-cache-dir flash-attn
Скачайте и распакуйте архив следующими командами:
wget -U Chrome https://hackware.ru/files/MiAl_AI_OCR_HunyuanOCR-1.5.zip
unzip MiAl_AI_OCR_HunyuanOCR-1.5.zip
Следующие пакеты нужны для сохранения текста после OCR в различных форматах.
В Arch Linux и производных дистрибутивах выполните установку следующим образом:
sudo pacman -S pandoc-cli texlive-basic texlive-latex texlive-latexrecommended texlive-latexextra texlive-xetex texlive-luatex noto-fonts noto-fonts-cjk noto-fonts-extra noto-fonts-emoji
pikaur -S otf-stix
В Debian, Kali Linux, Ubuntu и производных дистрибутивах для установки выполните команды:
sudo apt update
sudo apt install pandoc texlive-latex-base texlive-latex-recommended texlive-latex-extra texlive-xetex texlive-luatex texlive-fonts-extra fonts-noto fonts-noto-cjk fonts-noto-cjk-extra fonts-noto-extra fonts-noto-color-emoji
Примечание: в WSL выберите команду для Arch Linux или Debian в зависимости от того, какой дистрибутив вы используете в WSL.
Для запуска выполните команду:
uvicorn MiAl-HunyuanOCR:app --host localhost --port 8001
4.2 Как установить HunyuanOCR-1.5 на мобильном телефоне Android
Начните со статьи «Запуск ИИ на мобильных телефонах локально. Подготовка Android для запуска нейросетей».
В Termux войдите в Linux:
proot-distro login archlinux
Там выполните следующие команды:
micromamba create -n HunyuanOCR python -y
micromamba activate HunyuanOCR
pip install torch torchvision torchaudio torchcodec --index-url https://download.pytorch.org/whl/cpu
pip install uvicorn fastapi nvidia-ml-py accelerate pillow-heif huggingface-hub transformers Pillow PyMuPDF requests python-multipart
mkdir AI/HunyuanOCR
cd AI/HunyuanOCR
wget -U Chrome https://hackware.ru/files/MiAl_AI_OCR_HunyuanOCR-1.5.zip
unzip MiAl_AI_OCR_HunyuanOCR-1.5.zip
Выйдите из Linux, для этого нажмите Ctrl+d или введите команду:
exit
Затем, когда вы находитесь в Termux, скопируйте и вставьте в терминал сразу все следующие строки и нажмите Enter:
cat > HunyuanOCR.sh << 'EOF'
#!/data/data/com.termux/files/usr/bin/bash

# Запретить переход устройства в сон
termux-wake-lock

# Запустить команды внутри Arch Linux через proot
proot-distro login archlinux -- bash -c "
cd /root/AI/HunyuanOCR || exit 1
source ~/.bashrc
micromamba activate HunyuanOCR
uvicorn MiAl-HunyuanOCR:app --host localhost --port 8001
"
EOF
chmod +x HunyuanOCR.sh
Установите следующий пакет необходимый для конвертации текста после OCR в различные форматы:
pkg install pandoc
На телефоне можно запускать из Termux командой:
./HunyuanOCR.sh
Парочка видео работы HunyuanOCR-1.5 на телефоне. В этом видео я делаю фотографию листа с надписями и запускаю его OCR:
На этом видео делается распознавание текста на предварительно сделанном снимке информационного стенда:
5. Как пользоваться HunyuanOCR-1.5 с графическим интерфейсом для распознавания рукописного, печатного текста, формул и таблиц
Для запуска HunyuanOCR-1.5 выполните следующие команды:
cd ~/ai/HunyuanOCR
source venv/bin/activate
uvicorn MiAl-HunyuanOCR:app --host localhost --port 8001
Когда сервер будет запущен, то веб-интерфейс доступен по адресу http://localhost:8001.
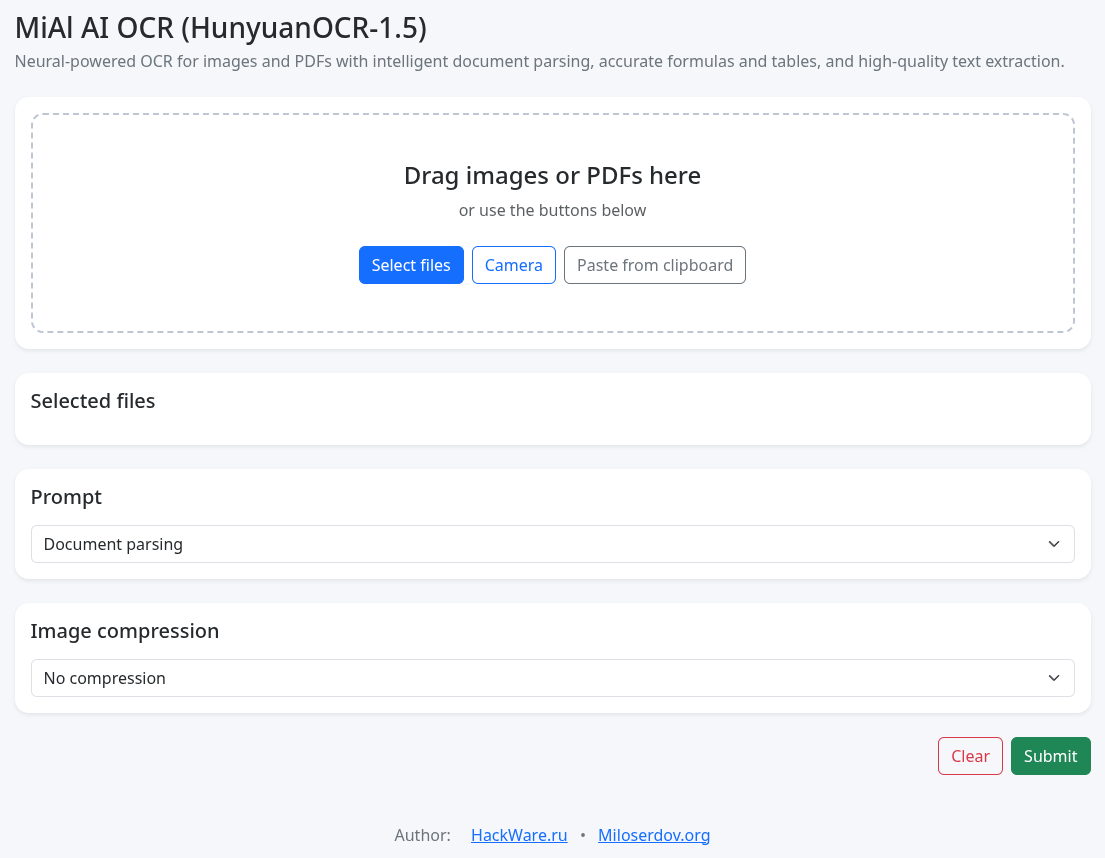
Вы можете добавить файлы любым из следующих способов:
- нажмите кнопку Select files и выберите файл (это может быть PDF файл, изображение в формате JPG, PNG, HEIC или в любом другом формате)
- сделайте снимок с помощью кнопки Camera
- нажмите Paste from clipboard для вставки из буфера обмена
- перетащите файл и бросьте его в соответствующую область веб-интерфейса
Для начала обработки нажмите кнопку Submit.
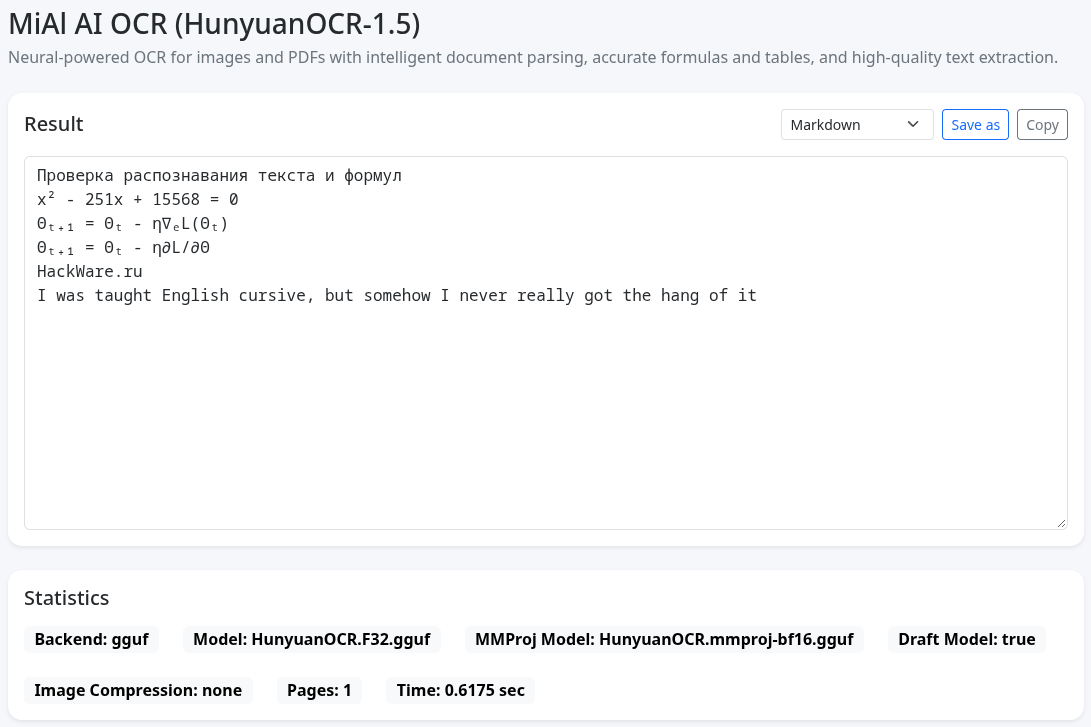
Тестовое изображение — ниже будут показаны скриншоты как различается вывод в зависимости от выбранной задачи:

В выпадающем списке Prompt вы можете ничего не менять или выбрать любую из следующих задач:
- Document parsing: Комбинация: OCR; структура документа; порядок чтения; таблицы → HTML; формулы → LaTeX; убрать header/footer. Итог — полноценная реконструкция документа. Подходит для большинства случаев
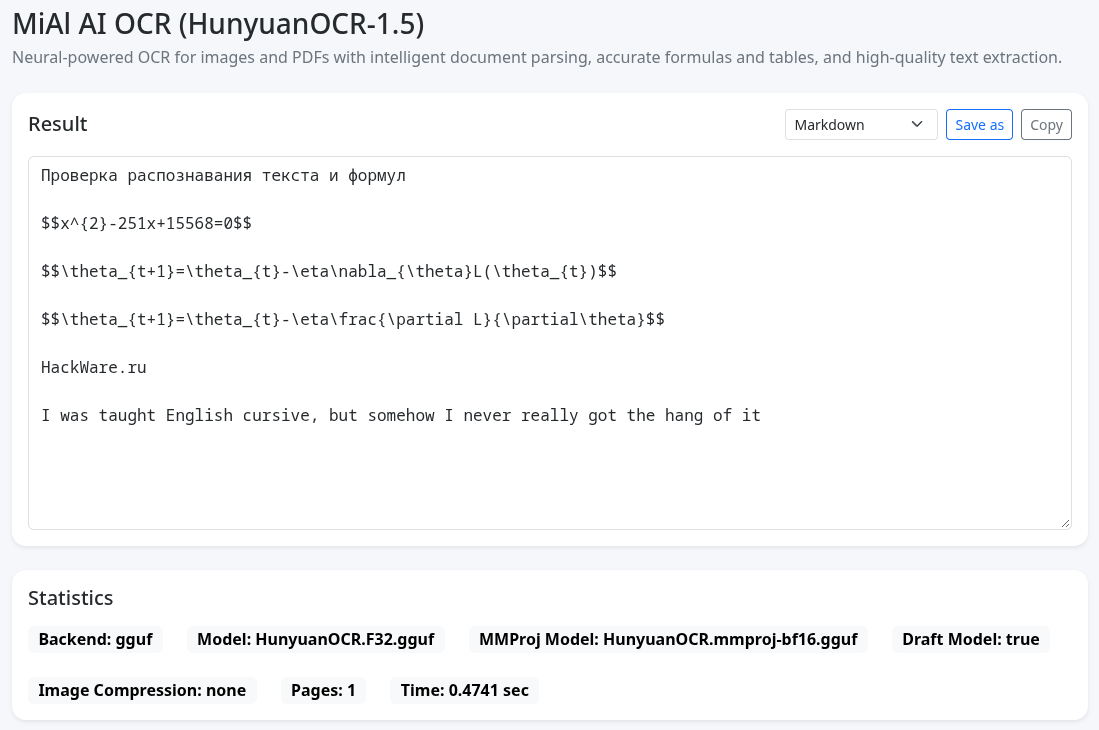
- Text extraction: Самый простой режим. Фактически OCR без анализа документа. Предназначен для: вывесок, любых документов где важен только текст, плакатов где понятия страниц вообще нет. Обратите внимание как записаны формулы — это не LaTeX-разметка, а обычные символы. На самом деле в моих тестах формулы выглядели по-разному — иногда там была и LaTeX-разметка.
- Text detection & recognition (JSON): OCR, координаты, JSON.
- Text detection & recognition (Hunyuan format): То же самое, но вывод в фирменном формате Tencent.
- Layout analysis: Только анализ структуры страницы. Практически без восстановления содержимого.
- Layout analysis + document parsing: Самый полный режим. Объединяет Layout analysis и Document parsing: помимо реконструкции содержимого возвращает ещё и информацию о структуре страницы.
- Chart analysis: Не OCR. А именно понимание диаграмм.
- Formula recognition (LaTeX): Только формулы.
- Table extraction (HTML): Только таблицы.
- Document translation (English → Chinese): Состоит из Document parsing + перевод.
- Translate content to English: Для любых изображений (не обязательно документов): OCR + структурирование + перевод в английский язык.
- Translate content to Chinese: То же самое, но перевод в китайский.
Проще говоря, Document parsing или Text extraction это то, что нужно в большинстве ситуаций.
В Image compression вы можете выбрать максимальный размер (любой) стороны изображения до которого оно будет сжато. Уменьшение размера очень сильно ускоряет обработку, но может повлиять на качество OCR. Размер меняется как для обычных картинок, так и для страниц файлов PDF.
Также размер картинок влияет на потребление памяти.
На мощных системах обычно нет особой нужды использовать Image compression, а на мобильных телефонах эта настройка фактически обязательная: рекомендуется выбирать максимальный размер стороны 1000 px. Это очень сильно ускорит обработку, а также снижает пиковое потребление памяти.
6. Сохранение результатов OCR
В правом верхнем углу области с результатом распознавания текста имеется выпадающий список с форматами в которых вы можете сохранить полученный результат:
- Markdown
- HTML
- HTML + MathJax
- HTML + KaTeX
- ODT
- DOCX
- EPUB
- LaTeX
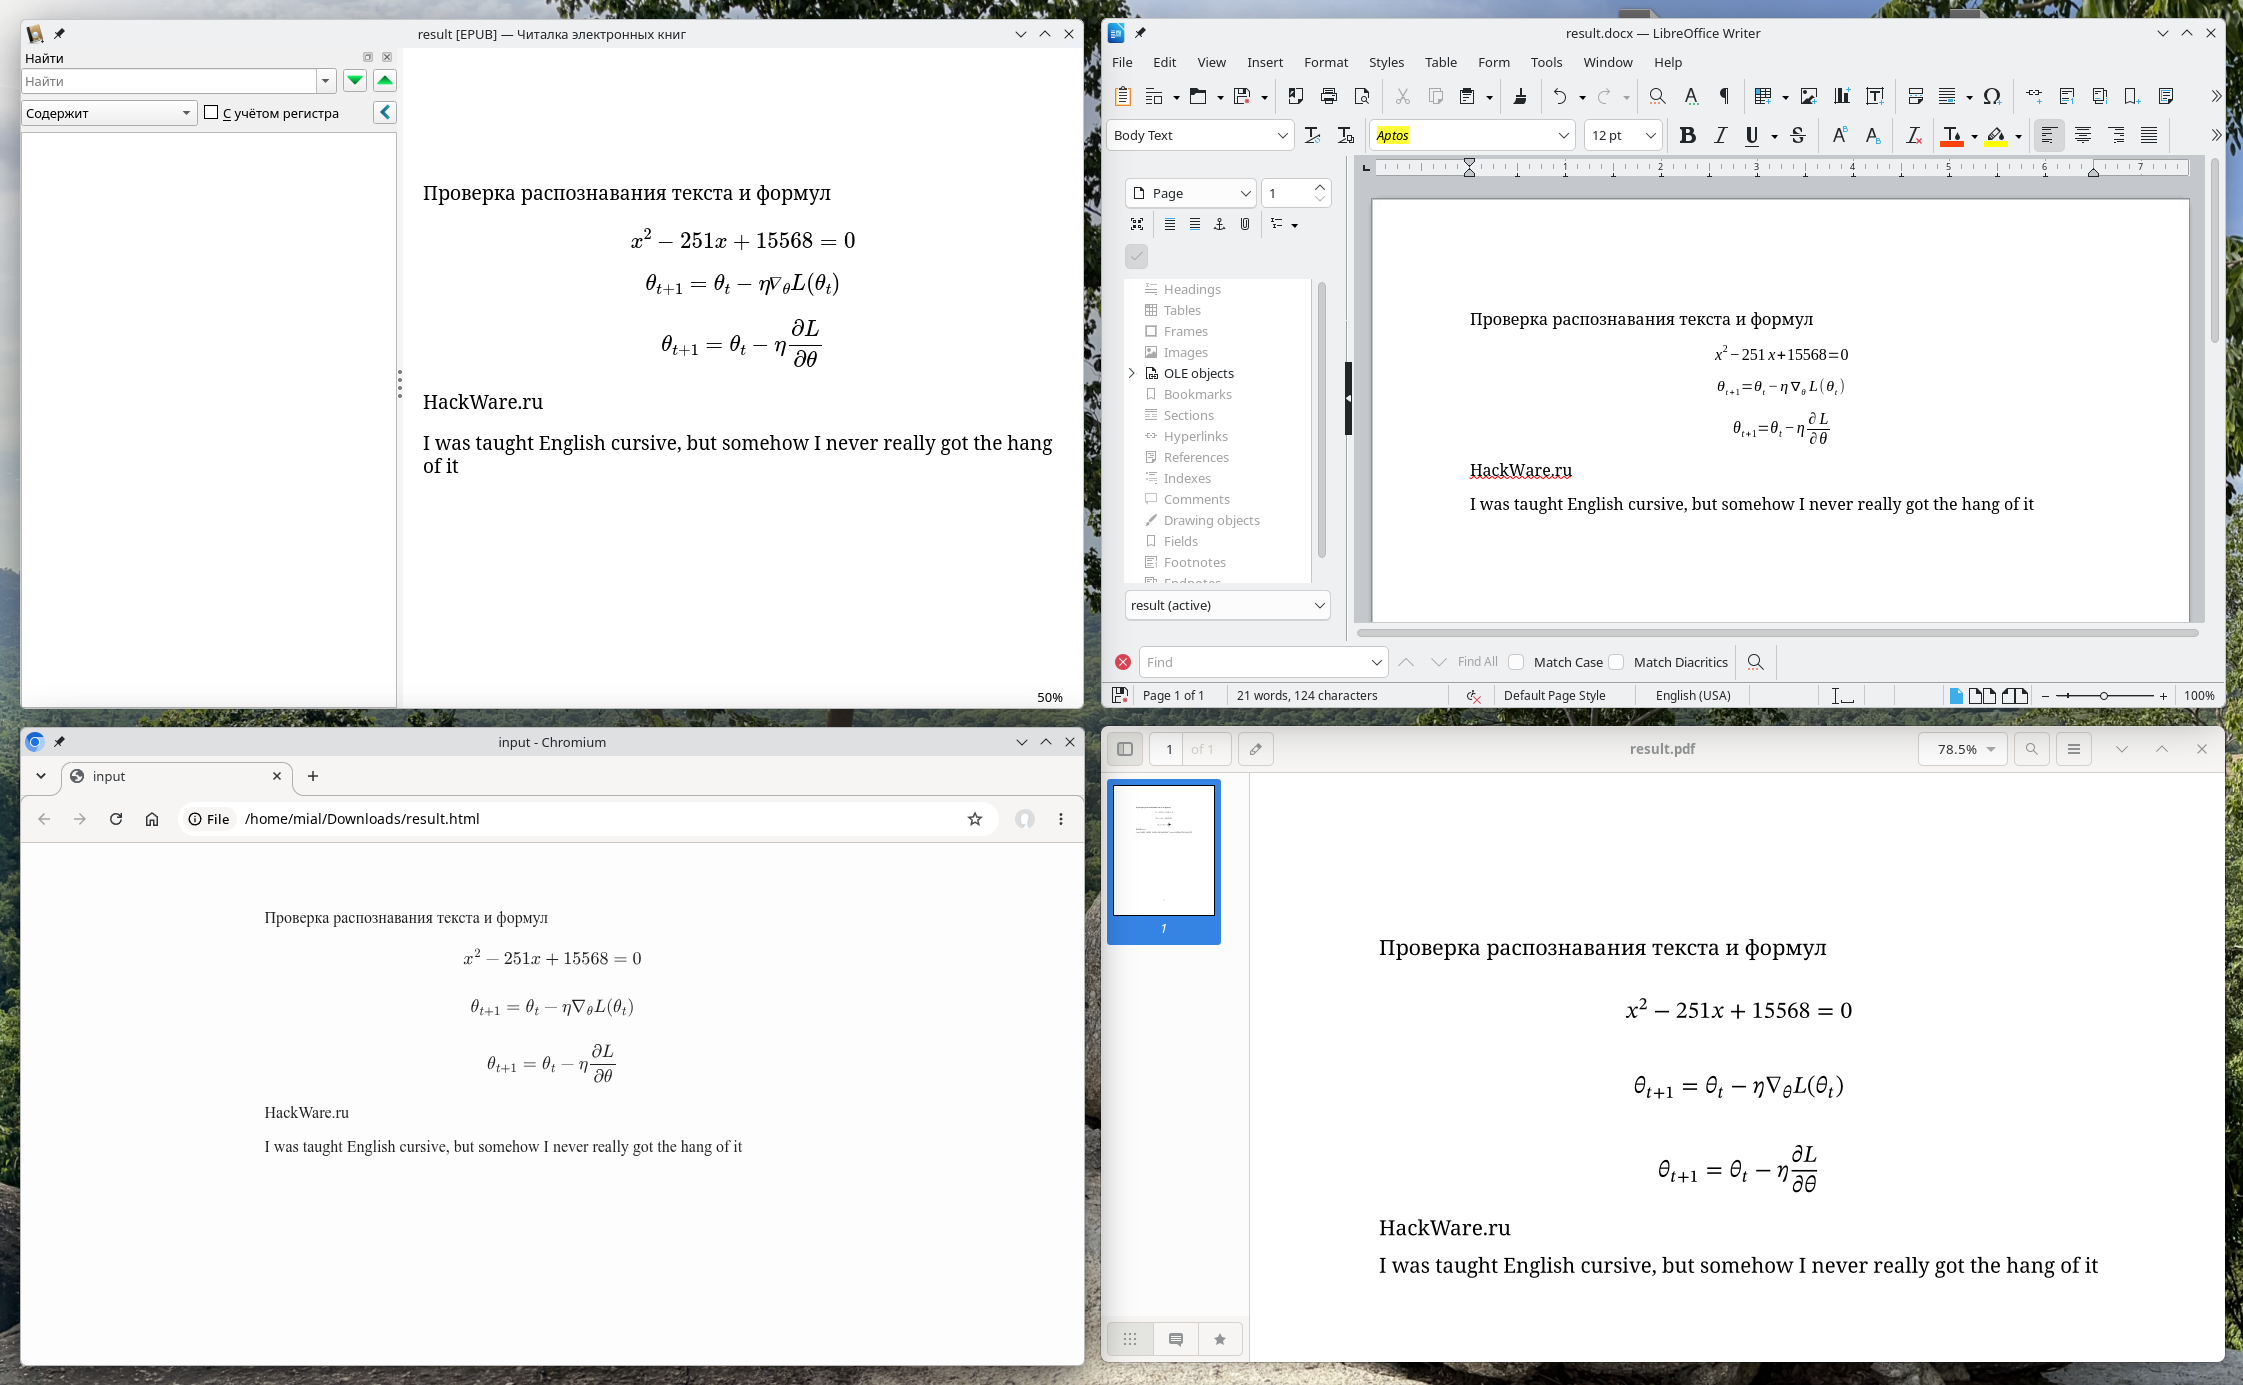
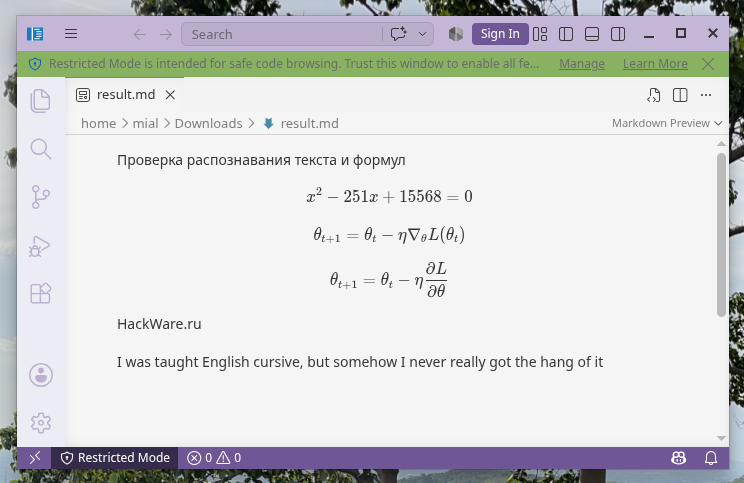
Что касается формата Markdown, то именно в этом формате модель выдаёт результат в режиме Document parsing. То есть можно сказать что это исходник который конвертируется в другие форматы.
При сохранении в формате Markdown вы можете посмотреть форматирование с помощью VS Code: откройте файл Markdown и нажмите Ctrl+Shift+V — откроется Markdown Preview.
7. Ускорение инференса HunyuanOCR-1.5 с помощью DFlash
Сквозное оптическое распознавание текста (end-to-end OCR) часто сопровождается длительным авторегрессионным декодированием (autoregressive decoding), которое становится основным узким местом при обработке плотных документов, таблиц, формул и других длинных структурированных результатов. HunyuanOCR-1.5 адаптирует фреймворк спекулятивного декодирования на основе DFlash: облегчённая черновая модель на основе блочной диффузии параллельно генерирует несколько вариантов токенов, после чего целевая модель проверяет их за один проход. Это значительно снижает задержку декодирования при получении длинных структурированных результатов, сохраняя при этом распределение выходных данных целевой модели.
Немного упрощённо суть процесса в следующем: черновая модель (более лёгкая и быстрая) генерирует токены. Затем основная модель за один проход проверяет эти токены. Если ошибки нет, то все токены принимаются и результат отправляется пользователю. Если найдена ошибка, то принимаются токены до ошибки, а начиная с ошибочного токена основная модель генерирует оставшиеся токены. Таким образом даже если черновая модель ошибается, эта ошибка исправляется.
Это lossless ускорение, то есть использование черновой модели не влияет на качество.
Что вам нужно знать про использование спекулятивного декодирования и черновой модели (DFlash):
1) Ускоряется только стадия генерации текста.
Напомню, работа HunyuanOCR-1.5 включает 2 стадии:
- визуальное кодирование изображения (visual encoding), на этой стадии DFlash ничего не ускоряет так как спекулятивное декодирование вообще не используется;
- и упомянутая чуть выше стадия авторегрессивного декодирования, ну или как её ещё можно назвать авторегрессивная генерация текста (autoregressive text generation), так вот, именно эту вторую стадию и ускоряет черновая модель.
То есть вполне возможна ситуация, что визуальное кодирование изображения занимает продолжительное время (картинка большого размера), а генерация выходных токенов занимает мало времени (на странице почти нет текста). В этой ситуации DFlash практически ничего не ускорит — даже если он сократит время генерации токенов в разы, это очень слабо отразится на всём времени работы модели.
2) Конкретное время ускорения может быть различным — возможны случаи, что работа черновой модели замедлит общую скорость работы модели. Поскольку черновая модель может ошибиться в любом месте, то ошибка может быть среди первых токенов. В этом случае почти всю генерацию токенов будет выполнять основная модель — то есть время работы почти такое же, как и без использования DFlash. Но предварительная работа черновой модели также требовала ресурсов и времени. В результате может получиться, что время работы модели не только не сократиться, но и увеличиться по сравнению с вариантом когда черновая модель вообще не запускалась.
Коротко говоря: использование черновой модели в большинстве обычных ситуаций заметно ускоряет получение результатов, но не нужно удивляться если в отдельных тестах скорость не увеличилась или даже уменьшилась.
В MiAl AI OCR (HunyuanOCR-1.5) за включение драфтовой модели отвечает опция:
USE_DRAFT_MODEL = True
В настоящее время в MiAl AI OCR (HunyuanOCR-1.5) черновая модель работает только с GGUF.
При использовании Transformers значение USE_DRAFT_MODEL молча переводится в False, так как я так и не разобрался как именно заставить вместе работать Transformers и DFlash.
А с vLLM включение USE_DRAFT_MODE в настоящее время вызывает ошибку. И дело (наверное) не в моём коде, так как с предыдущими версиями vLLM черновая модель работала и ускоряла. Но именно с последней на момент написания версией vLLM стала возникать ошибка.
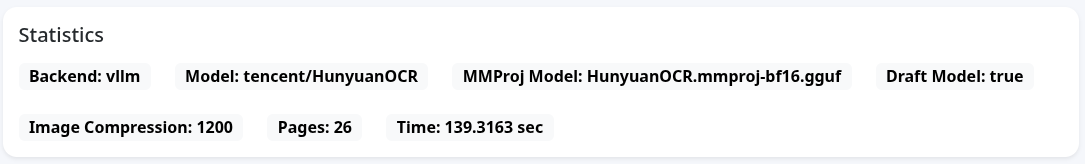
Просто откат на предыдущую версию vLLM не исправляет ситуацию: авторы модели обновили config.json и теперь он вызывает ошибку на старой версии vLLM. И всё это можно было бы исправить, но суть в том, что старая версия vLLM + DFlash в моих тестах работают медленнее, чем новая версия vLLM без DFlash. То есть вроде как совсем нет смысла этим заниматься.
Коротко говоря: ускорение с помощью DFlash в настоящее время работает только с GGUF который и без того самый быстрый бэкэнд для данной модели (в моих тестах). То есть выбор довольно очевиден.
8. Настройки сервера MiAl AI OCR (HunyuanOCR-1.5). Выбор модели и бэкэнда
Настройка серверной части HunyuanOCR-1.5 не требуется, но она доступна.
Прежде всего вы можете изменить MODEL и MMPROJ_MODEL чтобы использовать модели с разным квантованием:
MODEL = "HunyuanOCR.BF16.gguf"
MMPROJ_MODEL = "HunyuanOCR.mmproj-bf16.gguf"
Пример репозиториев с моделями которые я тестировал:
https://huggingface.co/ggml-org/HunyuanOCR-GGUF
HunyuanOCR-bf16.gguf
HunyuanOCR-Q8_0.gguf

mmproj-HunyuanOCR-bf16.gguf
mmproj-HunyuanOCR-Q8_0.gguf
===================================
https://huggingface.co/prithivMLmods/HunyuanOCR-1.5-GGUF-Updated
HunyuanOCR.F32.gguf
HunyuanOCR.BF16.gguf
HunyuanOCR.F16.gguf
HunyuanOCR.Q8_0.gguf
HunyuanOCR.Q5_K_M.gguf
HunyuanOCR.Q5_K_S.gguf
HunyuanOCR.Q4_K_M.gguf
HunyuanOCR.Q4_K_S.gguf
HunyuanOCR.Q3_K_L.gguf
HunyuanOCR.Q3_K_M.gguf
HunyuanOCR.Q3_K_S.gguf

HunyuanOCR.mmproj-bf16.gguf
HunyuanOCR.mmproj-f16.gguf
HunyuanOCR.mmproj-q8_0.gguf
Нет особого смысла переходить на сильно квантованные версии — это не ускоряет скорость инференса, а только снижает потребление памяти. В целом модель небольшая поэтому на большинстве устройств она должна целиком помещаться в память. Поэтому вы можете наоборот перейти с установленной по умолчанию HunyuanOCR.BF16.gguf на HunyuanOCR.F32.gguf.
Даже на телефоне я использую HunyuanOCR.BF16.gguf и HunyuanOCR.mmproj-bf16.gguf.
Вы можете использовать модели из других репозиториев, для этого укажите репозиторий в этой переменной (предыдущие два репозитория выбираются автоматически в зависимости от имени модели):
GGUF_REPO = "AUTO"
Если вы хотите использовать другой бэкэнд, то прежде всего в качестве модели нужно указать следующее:
MODEL = "tencent/HunyuanOCR"
Это важно, поскольку в моём коде при выборе GGUF модели значение BACKEND автоматически перезаписывается.
После этого вы можете указать "transformers" или "vllm" в качестве значения BACKEND:
BACKEND = "vllm"
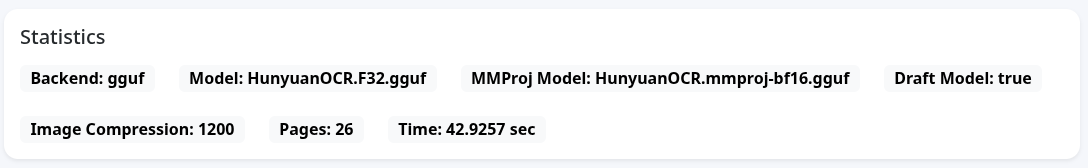
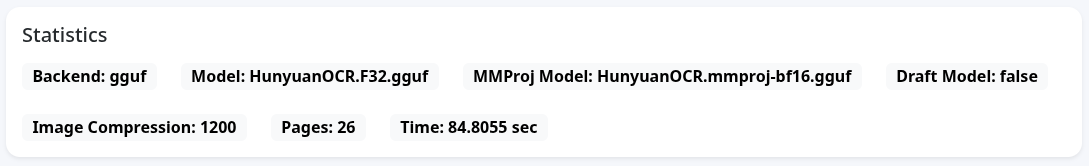
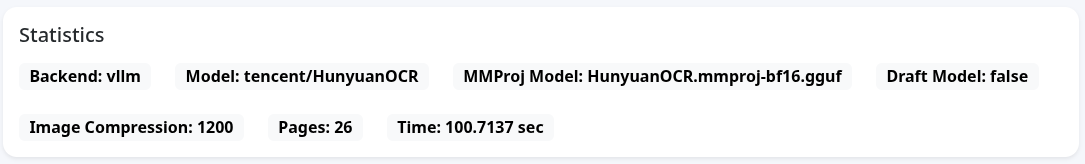
Вот мои тесты которые я получил на моём железе с теми настройками и оптимизациями которые вы можете видеть в исходном коде (я формирую батчи умеренного размера для эффективного использования видеокарты). Ваши результаты могут различаться.
Для тестов я взял довольно длинный PDF файл (26 страниц) с большим количеством формул и сложной структурой. Сначала я тестировал без сжатия изображений, но у меня появилось стойкое ощущение что vLLM читерит. На несжатых страницах этот бэкэнд показывает самые быстрые результаты, а если для всех бэкэндов выбрать сжатие страниц, то vLLM неожиданно начинает показывать весьма посредственные результаты (в плане скорости). То есть как будто бы vLLM немного сжимает слишком большие страницы на входе. В общем, для страниц среднего размера данные стали более адекватными.
- GGUF с DFlash (43 секунды)
- GGUF без DFlash (85 секунд)
- Последняя версия vLLM без DFlash (101 секунда)
- Transformers без DFlash (117 секунд)
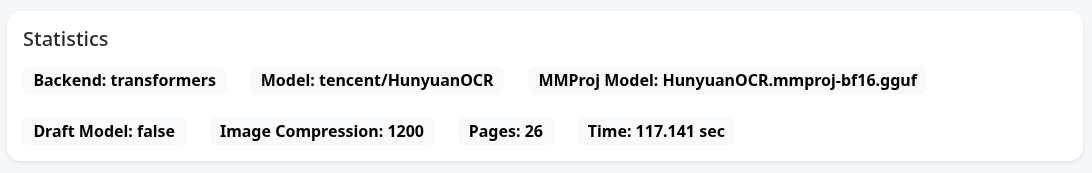
- vLLM старой версии с DFlash (139 секунд)
Связанные статьи:
- Запуск ИИ на мобильных телефонах локально. Подготовка Android для запуска нейросетей [ЧЕРНОВИК] (100%)
- Как запустить ComfyUI на Android: подробная инструкция и подбор моделей ИИ для генерации изображений на мобильном телефоне (87.4%)
- Подготовка Linux для локального запуска нейросетей (ИИ) (77%)
- Локальный ИИ переводчик высочайшего качества: 33 языка (инструкция по нейросетям Hy-MT2) (64.4%)
- 2. Как установить ComfyUI в Windows и Linux (52.8%)
- Руководство по VirtualBox (часть 1): Что такое VirtualBox, как установить и использовать (RANDOM - 0.5%)