Как извлечь вокал, инструментальную минусовку и отдельные стемы из песен на своём компьютере (инструкция по использованию Audio Separator)
Оглавление
1. Как извлечь вокал, инструментальную минусовку и отдельные стемы из песен на своём компьютере
2. Программа для удаления голоса из песни
3. Как установить Audio Separator
3.1 Как установить Audio Separator в Linux
3.2 Как установить Audio Separator в Windows
3.3 Как установить Audio Separator на телефонах Android
4. Как запустить и пользоваться Audio Separator
5. Как извлечь пение (вокал) из песни. Как удалить всю музыку и оставить только голос
6. Как удалить голос из песни и оставить только музыку. Как сделать караоке из песни
7. Модели для разделения вокала и музыки в песни
8. Как извлечь партии музыкальных инструментов из песни. Разделение на стемы
9. Ансамбль моделей (ensemble) для максимального качество в сепарации аудио
11. Как удалить шум, эхо и реверберацию из пения с помощью нейросетей
12. Как разделять голос и инструментальную часть в длинных песнях
14. Полезные опции Audio Separator
15. Как конвертировать FLAC в MP3
1. Как извлечь вокал, инструментальную минусовку и отдельные стемы из песен на своём компьютере
Эта инструкция расскажет как с помощью искусственного интеллекта и Audio Separator извлекать из песен голос, а также извлекать инструментальные партии без голоса (фонограммы минус один) — последнее можно использовать, например, для караоке. Также здесь будет показано как извлекать музыкальные партии отдельных инструментов, таких как барабаны, бас, пианино и гитара. И делать другую обработку аудио вроде уменьшения шума (денойзинг) и удаление эха/ревербирации.
Примечание: в этой статье в примерах в качестве исходных аудио (песен) я встроил видео с YouTube чтобы не загружать исходные файлы на хостинг, поскольку в них могут быть копирайты или что-то такое. Но на самом деле в своих тестах я использую исходную музыку в FLAC или другом lossless формате (если удалось найти, если lossless не нашёлся, то использую аудио из YouTube или других источников — mp3, m4a, opus и прочее). Хотя в конечном счёте для этой статьи полученные аудио дорожки всё-равно перекодированы в MP3.
Просто помните, что FLAC, WAV и другие lossless форматы поддерживаются из коробки в локальных нейросетях и Audio Separator.
Вы узнаете как запускать нейросети для разделения музыки на стемы на своём компьютере — поддерживаются все популярные ОС, в том числе Windows и Linux. При локальном запуске ИИ ваши файлы никуда не отправляются — максимальная приватность. У вас нет никаких ограничений на количество, длину обрабатываемых песен, также вы можете использовать lossless форматы (на некоторых онлайн сервисах эта опций предусмотрена только в платных пакетах). Вы можете делать быстрое разделение вокала и музыки одной простой командой, либо вникнуть в тонкие различия используемых для этого нейросетей, комбинировать несколько нейросетей последовательно или в ансамблях для максимально качественного результата.
В общем, вы сможете делать всё то же самое что и на платных онлайн сервисах, только ещё лучше и совершенно бесплатно.
Как обычно в статьях по локальным ИИ начнём с конкретных примеров, чтобы вы понимали чем именно мы сейчас будем заниматься и на какой результат можно рассчитывать.
1.
Исходная песня — развернуть
Вокал без музыки:
Музыка без вокала (инструментальная минусовка):
2.
Исходная песня — развернуть
Вокал без музыки:
Музыка без вокала (инструментальная минусовка):
3.
Исходная песня — развернуть
Вокал без музыки:
Музыка без вокала (инструментальная минусовка):
4.
Исходная песня — развернуть
Вокал без музыки:
Музыка без вокала (инструментальная минусовка):
5.
Исходная песня — развернуть
Вокал без музыки:
Музыка без вокала (инструментальная минусовка):
6.
Исходная песня — развернуть
Вокал без музыки:
Музыка без вокала (инструментальная минусовка):
7.
Исходная песня — развернуть
Вокал без музыки:
Музыка без вокала (инструментальная минусовка):
2. Программа для удаления голоса из песни
В этой инструкции мы в основном будем использовать Audio Separator, официальные страницы этой программы:
Примеры выше сделаны с помощью Audio Separator и локальных моделей ИИ, которые задействует эта программа.
Программа Audio Separator написана на Python, у неё открыт исходный код и она является бесплатной.
Audio Separator поддерживает большое количество нейросетей и позволяет их использовать одной простой командой — не требуется отдельная установка нейросетей, ручное скачивание файлов весов ИИ или файлов для инференса. Достаточно просто указать имя нейросети или не указывать ничего вовсе, чтобы использовать настройки по умолчанию.
Эта пошаговая инструкция по Audio Separator охватывает как базовое использование этой программы, так и более продвинутые техники с рекомендациями какие нейросети выбирать в зависимости от конкретных задач по разделению голоса и музыки, а также как выполнять сопутствующую очистку, например, от просачивающихся музыкальных инструментов или вокала, как делать денойзинг, удалять эхо и реверберации.
Хотя Audio Separator является утилитой командной строки, она очень проста в использовании. Детальные инструкции по установке и использованию Audio Separator позволят вам легко разделять музыку на стемы в том числе и в Windows.
3. Как установить Audio Separator
3.1 Как установить Audio Separator в Linux
Рекомендуется начать с установки драйверов видеокарты и пакетов которые почти всегда требуются при локальном запуске нейросетей, как это сделать смотрите в статье: Подготовка Linux для локального запуска нейросетей (ИИ)
Затем выполните следующие команды для поддержки аппаратного ускорения в Audio Separator на видеокартах NVIDIA:
eval "$(micromamba shell hook --shell bash)"
micromamba create -n audio-separator python=3.12 -y
micromamba activate audio-separator
pip install "audio-separator[gpu]"
Проверка что установка прошла успешно и что включено аппаратное ускорение:
audio-separator --env_info
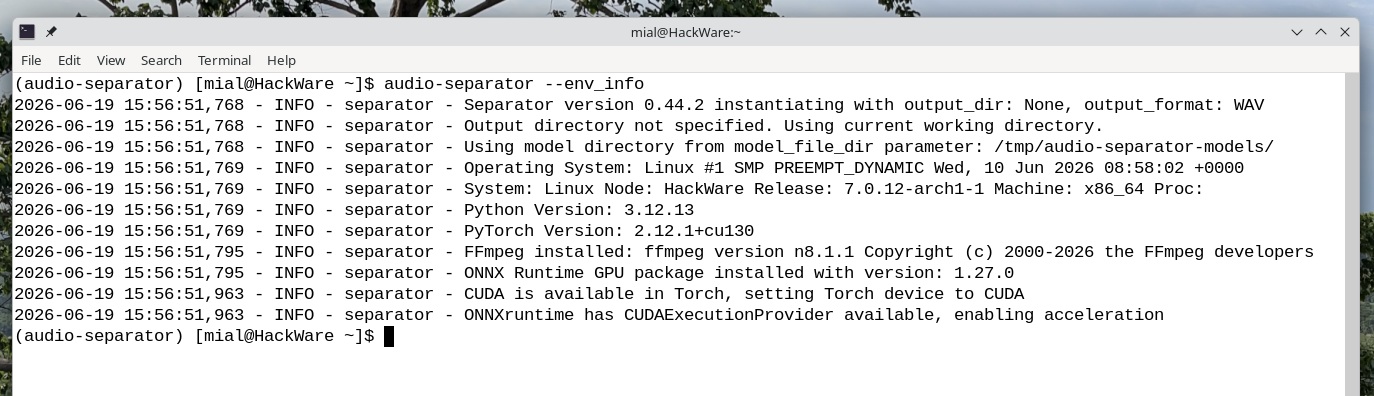
О поддержке аппаратного ускорения говорят следующие строки:
2026-06-19 15:56:51,795 - INFO - separator - ONNX Runtime GPU package installed with version: 1.27.0
2026-06-19 15:56:51,963 - INFO - separator - CUDA is available in Torch, setting Torch device to CUDA
2026-06-19 15:56:51,963 - INFO - separator - ONNXruntime has CUDAExecutionProvider available, enabling acceleration
Если вы хотите установить Audio Separator без аппаратного ускорения, чтобы эта программа работала только на центральной процессоре, тогда команды следующие:
eval "$(micromamba shell hook --shell bash)"
micromamba create -n audio-separator python=3.12 -y
micromamba activate audio-separator
pip install "audio-separator[cpu]"
Для последующих запусков Audio Separator (например, после закрытия терминала, перезагрузки ОС) достаточно активировать виртуальное окружение:
eval "$(micromamba shell hook --shell bash)"
micromamba activate audio-separator
Обратите внимание, что Micromamba создаёт виртуальное окружение не в текущей папке, а в специальной директории.
Смотрите также: Как создавать виртуальные окружения с любой версией Python (инструкция по использованию Micromamba)
Для обновления Audio Separator используйте команды:
eval "$(micromamba shell hook --shell bash)"
micromamba activate audio-separator
Затем для обновления версии с аппаратным ускорением:
pip install -U "audio-separator[gpu]"
Либо для обновления версии работающий на центральном процессоре:
pip install -U "audio-separator[cpu]"
3.2 Как установить Audio Separator в Windows
Начните со статьи «Как настроить Windows для запуска любых нейросетей (ИИ) на своём компьютере».
Затем запустите WSL и выполните следующие команды:
eval "$(micromamba shell hook --shell bash)"
micromamba create -n audio-separator python=3.12 -y
micromamba activate audio-separator
Если вы хотите использовать аппаратное ускорение (видеокарту NVIDIA), то выполните команду:
pip install "audio-separator[gpu]"
Если вы хотите запускать Audio Separator исключительно на центральном процессоре (это медленнее), то вместо предыдущей выполните команду:
pip install "audio-separator[cpu]"
Чтобы проверить, что всё прошло успешно, выполните команду:
audio-separator --env_info
В дальнейшем (например, после выключения WSL или перезагрузки Windows) для использования Audio Separator в Windows, запустите WSL:
wsl
И выполните следующие команды:
eval "$(micromamba shell hook --shell bash)"
micromamba activate audio-separator
Для обновления Audio Separator используйте команды:
wsl
eval "$(micromamba shell hook --shell bash)"
micromamba activate audio-separator
Затем для обновления версии с аппаратным ускорением:
pip install -U "audio-separator[gpu]"
Либо для обновления версии работающий на центральном процессоре:
pip install -U "audio-separator[cpu]"
Примечание: если вы пользователь Windows и у вас не NVIDIA видеокарта (а, например, AMD, Intel Arc / Intel Xe, или всё-таки NVIDIA, но у вас какие-то проблемы с CUDA) и вы хотите использовать аппаратное ускорение, то предусмотрен пакет audio-separator[dml] (DirectML работающий поверх DirectX 12 и поддерживающий все основные видеокарты) который нужно ставить в связку Windows + Python без WSL, но это выходит за рамки данной статьи.
3.3 Как установить Audio Separator на телефонах Android
Начните со статьи «Запуск ИИ на мобильных телефонах».
ЗДЕСЬ БУДЕТ ССЫЛКА
[TBD]
4. Как запустить и пользоваться Audio Separator
Audio Separator может использоваться как утилита командной строки и как зависимость в проектах Python.
Простым и подходящим для большинства случаев является запуск Audio Separator как утилиты командной строки.
Чтобы исполнимый файл Audio Separator стал доступен достаточно просто активировать окружение, в которое вы установили пакет audio-separator. Для начала инициализируйте Micromamba если не настроили постоянную инициализацию:
eval "$(micromamba shell hook --shell bash)"
А затем активируйте окружение:
micromamba activate audio-separator
Теперь Audio Separator доступен в качестве утилиты командной строки:
audio-separator --help
Audio Separator доступен из любой директории, но для удобной работы с вашими аудиофайлами вы можете создать директорию и перейти в неё:
mkdir -p ~/ai/tests/audio-separator/
cd ~/ai/tests/audio-separator/
Скопируйте ваши аудиофайлы в ~/ai/tests/audio-separator/. Либо указывайте абсолютный путь до файлов в командах ниже.
5. Как извлечь пение (вокал) из песни. Как удалить всю музыку и оставить только голос
В следующих командах замените FILE.flac наа имя файла который вы хотите обработать.
Простейший способ использования Audio Separator — достаточно указать только имя файла:
audio-separator "FILE.flac"
Например:
audio-separator "03. Love You More.mp3"
При первом запуске, а также при первом использовании новых моделей, вначале будут загружены файлы весов нейросетей. Ниже мы поговорим куда именно они загружаются, как это влияет на расход оперативной памяти и как сделать так, чтобы файлы нейросетей сохранялись после перезагрузки компьютера.
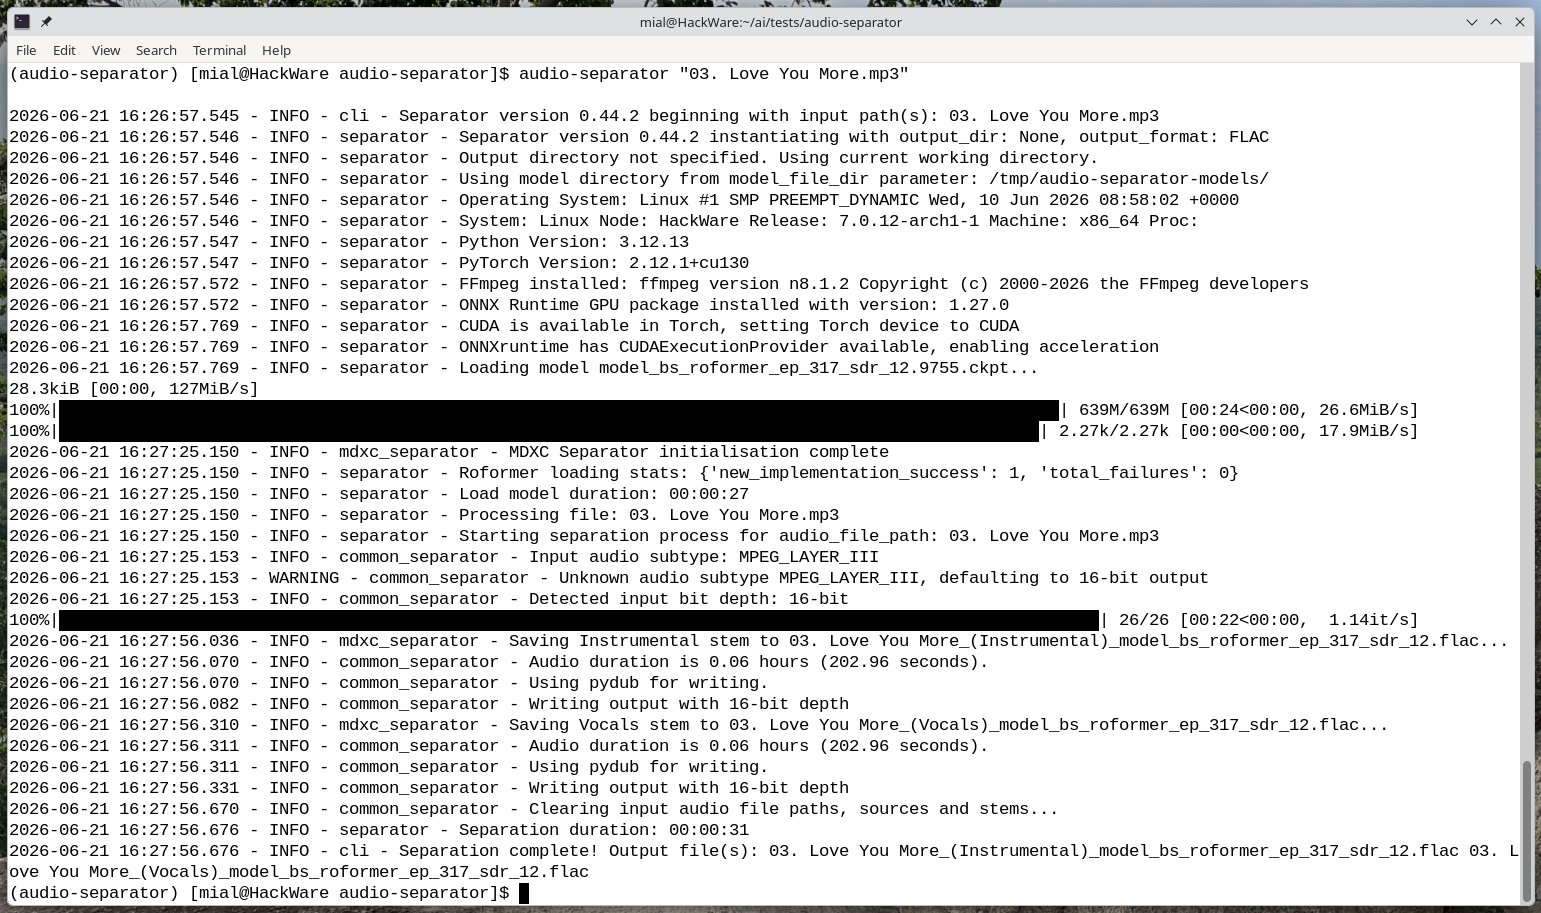
По умолчанию будет использоваться нейросеть model_bs_roformer_ep_317_sdr_12.9755.ckpt.
После завершения работы программы будут сохранены 2 файлы, имя которых составлено из названия исходного файла, а также имени используемой нейросети. В именах будет слово «Vocals» (голос) или «Instrumental» (инструментальная партия без голоса), например:
- 03. Love You More_(Vocals)_model_bs_roformer_ep_317_sdr_12.flac
- 03. Love You More_(Instrumental)_model_bs_roformer_ep_317_sdr_12.flac
Исходная песня — развернуть
Если вам нужна только одна стема, то укажите её с помощью опции —single_stem. К примеру, для сохранения только голоса:
audio-separator --single_stem Vocals "FILE.flac"
Для сохранения только инструментальной минусовки:
audio-separator --single_stem Instrumental "FILE.flac"
Использование —single_stem не ускоряет обработку — использование этой опции приводит только к тому, что файлы с другими стемами не сохраняются.
Существует большое количество ИИ моделей, которые разделяют песню на голос и инструментальную партию. Они могут быть лучше или хуже, но обычно непросто выделить лучшую модель — для разных жанров или для разных музыкальных композиций, а также для разных целей (приятная а капелла или максимально изолированный от музыкальных инструментов голос даже если он звучит суши и прочее) разные модели могут показать себя лучше или хуже.
Если вас не устраивает качество звука или вы хотите экспериментировать, то пробуйте разные модели — для этого указывайте имя модели после опции -m, например:
audio-separator -m vocals_mel_band_roformer.ckpt "FILE.flac"
Пример реальной команды:
audio-separator -m vocals_mel_band_roformer.ckpt "Когда ты грустишь (128kbit_AAC).m4a"
По умолчанию в имена файлов записывается название используемой модели (или пресета ансамблей моделей), это поведение можно изменить опциями, но на самом деле это очень удобно, особенно в процессе сравнения качества звука полученного в результате работы разных моделей.
Полученные в результате разделения аудио файлы (обратите внимание на название модели в именах):
- Когда ты грустишь (128kbit_AAC)_(vocals)_vocals_mel_band_roformer.flac
- Когда ты грустишь (128kbit_AAC)_(other)_vocals_mel_band_roformer.flac
Исходная песня — развернуть
Ниже будет показано как посмотреть полный список моделей и составить список наиболее подходящих под те или иные задачи модели, а пока подборка весьма качественных моделей для хорошего старта:
- model_bs_roformer_ep_368_sdr_12.9628.ckpt
- melband_roformer_instvox_duality_v2.ckpt
- mel_band_roformer_kim_ft_unwa.ckpt
- vocals_mel_band_roformer.ckpt
- htdemucs_ft.yaml
- MDX23C-8KFFT-InstVoc_HQ_2.ckpt
- bs_roformer_vocals_resurrection_unwa.ckpt
- melband_roformer_big_beta6x.ckpt
- melband_roformer_big_beta6.ckpt
- bs_roformer_vocals_revive_v3e_unwa.ckpt
Также имеется мнение, что лучшего результата можно достичь ансамблем (комбинированием) моделей. Причём речь идёт не о последовательной обработке, а об одновременной обработки файла разными моделями, а затем объединение результатов с помощью того или иного алгоритма (их несколько). То есть ансамбль – это не «вторая модель улучшает первую», а скорее: «несколько независимых мнений объединяются математически».
Ниже мы рассмотрим опции используемые для ансамблей моделей — это скорее для продвинутых пользователей. Для обычных пользователей имеется несколько пресетов ансамблей, которые вы можете очень легко использовать с помощью опции —ensemble_preset. К примеру, для ансамбля с лучшим вокалом (так указано в описании, я бы не сказал что таким образом всегда получается лучший вокал) используйте пресет vocal_balanced:
audio-separator --ensemble_preset vocal_balanced "FILE.flac"
Если в вокал просачиваются музыкальные инструменты, то попробуйте специально предназначенный для этих случаев пресет vocal_clean:
audio-separator --ensemble_preset vocal_clean "FILE.flac"
Я тестировал ансамбли и отдельные модели и не могу сказать что ансамбли всегда лучше — многое действительно зависит от исходной музыкальной композиции и иногда правильно подобранная модель даёт нужный результат.
Пример использования ансамблей моделей:
audio-separator --ensemble_preset vocal_balanced "02 - I Feel Like You 555.flac"
Полученный результат:
- 02 — I Feel Like You 555_(Vocals)_preset_vocal_balanced.flac
- 02 — I Feel Like You 555_(Instrumental)_preset_vocal_balanced.flac
Исходная песня — развернуть
6. Как удалить голос из песни и оставить только музыку. Как сделать караоке из песни
Во всех показанных выше вариантах отделения голоса от инструментов создаются 2 файла — один из которых инструментальные партии песни. Для многих случаев когда вам нужен инструментальная минусовка, вам могут подойти эти музыкальные стемы.
В том числе запуск Audio Separator вовсе без каких-либо опций даст вам очень хорошее разделение песни на голос и музыку, поскольку по умолчанию используется отличная модель model_bs_roformer_ep_317_sdr_12.9755.ckpt, которая даёт хорошие результаты и для голоса и для музыки.
Тем не менее, имеются модели задача которых максимально качественно убрать из музыки голос чтобы получить наилучшую инструментальную минусовку. При этом модели также извлекают и голос, но это не является их главной задачей. То есть для качества извлечённой музыки они получают более высокие оценки в бенчмарках, а для качества извлечения голоса получают более низкие показатели в бенчмарках.
Примечание: не смотря на некоторую объективность, наилучшая оценка в бенчмарке не равно наиболее приятной для прослушивания версии. То есть лучше всего попробовать разные модели и выбрать наиболее понравившийся результат.
Хорошая подборка моделей для старта в получении наиболее качественного инструментальной минусовки:
- melband_roformer_instvox_duality_v2.ckpt
- bs_roformer_instrumental_resurrection_unwa.ckpt
- mel_band_roformer_instrumental_instv8_gabox.ckpt
- melband_roformer_inst_v2.ckpt
- mel_band_roformer_instrumental_fv7z_gabox.ckpt
- mel_band_roformer_instrumental_bleedless_v3_gabox.ckpt
- model_bs_roformer_ep_368_sdr_12.9628.ckpt
Напомню, эти модели нужно указывать с опцией -m:
audio-separator -m melband_roformer_instvox_duality_v2.ckpt "FILE.flac"
Для достижения максимальных показателей в качестве звука имеется несколько пресетов ансамблей моделей, например:
- instrumental_full — максимальное сохранение инструментальных партий
- instrumental_clean — наиболее чистые инструментальные композиции с минимальным проникновением вокала
Название пресета нужно указывать после опции —ensemble_preset:
audio-separator --ensemble_preset instrumental_full "FILE.flac"
Пример использования ансамбля моделей с акцентом на полноту и качество инструментальной партии:
audio-separator --ensemble_preset instrumental_full "SEMARGL - Credo Revolution (Zardonic Remix) (128kbit_AAC).m4a"
Полученные результаты:
- SEMARGL — Credo Revolution (Zardonic Remix) (128kbit_AAC)_(Instrumental)_preset_instrumental_full.flac
- SEMARGL — Credo Revolution (Zardonic Remix) (128kbit_AAC)_(Vocals)_preset_instrumental_full.flac
Исходная песня — развернуть
7. Модели для разделения вокала и музыки в песни
Моделей для разделения песен на стемы огромное количество. Их можно классифицировать по используемой архитектуре (VR, MDX, Demucs, MDXC), условно можно разделить на поколения (очень старые VR UVR; старые, но всё ещё хорошие MDX-Net и Demucs; современные и сильные MDX23C; текущий high-end BS Roformer и MelBand Roformer; современные с тюнингом unwa/gabox/viperx/kimberley), отдельно можно выделить модели от сообщества (ViperX, Gabox, Unwa, Kimberley Jensen, jarredou, SYH99999, Sucial, anvuew, Aname, becruily)
Также модели можно классифицировать по получаемому результату:
- 2 стемы (голос и музыка)
- несколько стем с голосом и отдельными инструментами
- специализированные модели для извлечения определённого инструмента
- специализированные модели для подавления шума, очистки, удаления эха и реверберации, фильтрации дыхания и прочие
Для вывода всех моделей которые поддерживает Audio Separator выполните следующую команду:
audio-separator -l
Вы увидите следующий список:
Развернуть
Model Filename
Arch
Output Stems (SDR)
Friendly Name
1_HP-UVR.pth
VR
instrumental* (13.7), vocals (7.9)
VR Arch Single Model v5: 1_HP-UVR
2_HP-UVR.pth
VR
instrumental* (13.5), vocals (8.2)
VR Arch Single Model v5: 2_HP-UVR
3_HP-Vocal-UVR.pth
VR
vocals* (8.2), instrumental (14.0)
VR Arch Single Model v5: 3_HP-Vocal-UVR
4_HP-Vocal-UVR.pth
VR
vocals* (8.3), instrumental (13.6)
VR Arch Single Model v5: 4_HP-Vocal-UVR
5_HP-Karaoke-UVR.pth
VR
instrumental* (12.2), vocals (5.2)
VR Arch Single Model v5: 5_HP-Karaoke-UVR
6_HP-Karaoke-UVR.pth
VR
instrumental* (13.0), vocals (4.6)
VR Arch Single Model v5: 6_HP-Karaoke-UVR
7_HP2-UVR.pth
VR
instrumental* (13.5), vocals (8.3)
VR Arch Single Model v5: 7_HP2-UVR
8_HP2-UVR.pth
VR
instrumental* (13.5), vocals (8.2)
VR Arch Single Model v5: 8_HP2-UVR
9_HP2-UVR.pth
VR
instrumental* (13.7), vocals (8.0)
VR Arch Single Model v5: 9_HP2-UVR
10_SP-UVR-2B-32000-1.pth
VR
instrumental* (13.3), vocals (7.5)
VR Arch Single Model v5: 10_SP-UVR-2B-32000-1
11_SP-UVR-2B-32000-2.pth
VR
instrumental* (13.8), vocals (7.3)
VR Arch Single Model v5: 11_SP-UVR-2B-32000-2
12_SP-UVR-3B-44100.pth
VR
instrumental* (13.1), vocals (7.5)
VR Arch Single Model v5: 12_SP-UVR-3B-44100
13_SP-UVR-4B-44100-1.pth
VR
instrumental* (13.3), vocals (7.8)
VR Arch Single Model v5: 13_SP-UVR-4B-44100-1
14_SP-UVR-4B-44100-2.pth
VR
instrumental* (13.5), vocals (8.0)
VR Arch Single Model v5: 14_SP-UVR-4B-44100-2
15_SP-UVR-MID-44100-1.pth
VR
instrumental* (13.1), vocals (7.5)
VR Arch Single Model v5: 15_SP-UVR-MID-44100-1
16_SP-UVR-MID-44100-2.pth
VR
instrumental* (13.3), vocals (7.4)
VR Arch Single Model v5: 16_SP-UVR-MID-44100-2
17_HP-Wind_Inst-UVR.pth
VR
no woodwinds*, woodwinds
VR Arch Single Model v5: 17_HP-Wind_Inst-UVR
UVR-De-Echo-Aggressive.pth
VR
no echo*, echo
VR Arch Single Model v5: UVR-De-Echo-Aggressive by FoxJoy
UVR-De-Echo-Normal.pth
VR
no echo*, echo
VR Arch Single Model v5: UVR-De-Echo-Normal by FoxJoy
UVR-DeEcho-DeReverb.pth
VR
no reverb*, reverb
VR Arch Single Model v5: UVR-DeEcho-DeReverb by FoxJoy
UVR-DeNoise-Lite.pth
VR
noise*, no noise
VR Arch Single Model v5: UVR-DeNoise-Lite by FoxJoy
UVR-DeNoise.pth
VR
noise*, no noise
VR Arch Single Model v5: UVR-DeNoise by FoxJoy
UVR-BVE-4B_SN-44100-1.pth
VR
vocals* (0.0), instrumental (7.7)
VR Arch Single Model v5: UVR-BVE-4B_SN-44100-1
MGM_HIGHEND_v4.pth
VR
instrumental* (12.3), vocals (6.9)
VR Arch Single Model v4: MGM_HIGHEND_v4
MGM_LOWEND_A_v4.pth
VR
instrumental* (13.0), vocals (7.0)
VR Arch Single Model v4: MGM_LOWEND_A_v4
MGM_LOWEND_B_v4.pth
VR
instrumental* (13.1), vocals (7.5)
VR Arch Single Model v4: MGM_LOWEND_B_v4
MGM_MAIN_v4.pth
VR
instrumental* (12.4), vocals (6.2)
VR Arch Single Model v4: MGM_MAIN_v4
UVR-De-Reverb-aufr33-jarredou.pth
VR
dry*, no dry
VR Arch Single Model v4: UVR-De-Reverb by aufr33-jarredou
UVR-BVE-4B_SN-44100-2.pth
VR
Unknown
VR Arch Single Model v5: UVR-BVE-4B_SN-44100-2
UVR-MDX-NET-Inst_HQ_1.onnx
MDX
instrumental* (15.4), vocals (8.8)
MDX-Net Model: UVR-MDX-NET Inst HQ 1
UVR-MDX-NET-Inst_HQ_2.onnx
MDX
instrumental* (15.3), vocals (8.8)
MDX-Net Model: UVR-MDX-NET Inst HQ 2
UVR-MDX-NET-Inst_HQ_3.onnx
MDX
instrumental* (15.4), vocals (8.8)
MDX-Net Model: UVR-MDX-NET Inst HQ 3
UVR-MDX-NET-Inst_HQ_4.onnx
MDX
instrumental* (15.5), vocals (8.8)
MDX-Net Model: UVR-MDX-NET Inst HQ 4
UVR-MDX-NET-Inst_HQ_5.onnx
MDX
instrumental* (15.3), vocals (8.7)
MDX-Net Model: UVR-MDX-NET Inst HQ 5
UVR_MDXNET_Main.onnx
MDX
vocals* (10.2), instrumental (15.4)
MDX-Net Model: UVR-MDX-NET Main
UVR-MDX-NET-Inst_Main.onnx
MDX
instrumental* (15.1), vocals (8.5)
MDX-Net Model: UVR-MDX-NET Inst Main
UVR_MDXNET_1_9703.onnx
MDX
vocals* (9.6), instrumental (15.0)
MDX-Net Model: UVR-MDX-NET 1
UVR_MDXNET_2_9682.onnx
MDX
vocals* (9.4), instrumental (15.0)
MDX-Net Model: UVR-MDX-NET 2
UVR_MDXNET_3_9662.onnx
MDX
vocals* (9.7), instrumental (15.0)
MDX-Net Model: UVR-MDX-NET 3
UVR-MDX-NET-Inst_1.onnx
MDX
instrumental* (15.2), vocals (9.2)
MDX-Net Model: UVR-MDX-NET Inst 1
UVR-MDX-NET-Inst_2.onnx
MDX
instrumental* (15.3), vocals (9.2)
MDX-Net Model: UVR-MDX-NET Inst 2
UVR-MDX-NET-Inst_3.onnx
MDX
instrumental* (15.3), vocals (9.2)
MDX-Net Model: UVR-MDX-NET Inst 3
UVR_MDXNET_KARA.onnx
MDX
vocals* (5.6), instrumental (14.1)
MDX-Net Model: UVR-MDX-NET Karaoke
UVR_MDXNET_KARA_2.onnx
MDX
instrumental* (14.8), vocals (5.4)
MDX-Net Model: UVR-MDX-NET Karaoke 2
UVR_MDXNET_9482.onnx
MDX
vocals* (9.3), instrumental (14.9)
MDX-Net Model: UVR_MDXNET_9482
UVR-MDX-NET-Voc_FT.onnx
MDX
vocals* (10.2), instrumental (15.4)
MDX-Net Model: UVR-MDX-NET Voc FT
Kim_Vocal_1.onnx
MDX
vocals* (10.1), instrumental (15.5)
MDX-Net Model: Kim Vocal 1
Kim_Vocal_2.onnx
MDX
vocals* (10.2), instrumental (15.4)
MDX-Net Model: Kim Vocal 2
Kim_Inst.onnx
MDX
instrumental* (15.5), vocals (9.1)
MDX-Net Model: Kim Inst
Reverb_HQ_By_FoxJoy.onnx
MDX
reverb*, no reverb
MDX-Net Model: Reverb HQ By FoxJoy
UVR-MDX-NET_Crowd_HQ_1.onnx
MDX
no crowd*, crowd
MDX-Net Model: UVR-MDX-NET Crowd HQ 1 By Aufr33
kuielab_a_vocals.onnx
MDX
vocals* (9.6), instrumental (15.3)
MDX-Net Model: kuielab_a_vocals
kuielab_a_other.onnx
MDX
other*, no other
MDX-Net Model: kuielab_a_other
kuielab_a_bass.onnx
MDX
bass* (10.4), no bass
MDX-Net Model: kuielab_a_bass
kuielab_a_drums.onnx
MDX
drums* (7.0), no drums
MDX-Net Model: kuielab_a_drums
kuielab_b_vocals.onnx
MDX
vocals* (9.0), instrumental (15.1)
MDX-Net Model: kuielab_b_vocals
kuielab_b_other.onnx
MDX
other*, no other
MDX-Net Model: kuielab_b_other
kuielab_b_bass.onnx
MDX
bass* (9.9), no bass
MDX-Net Model: kuielab_b_bass
kuielab_b_drums.onnx
MDX
drums* (7.1), no drums
MDX-Net Model: kuielab_b_drums
UVR-MDX-NET_Main_340.onnx
MDX
vocals* (10.2), instrumental (15.4)
MDX-Net Model VIP: UVR-MDX-NET_Main_340
UVR-MDX-NET_Main_390.onnx
MDX
vocals* (4.5), instrumental (8.8)
MDX-Net Model VIP: UVR-MDX-NET_Main_390
UVR-MDX-NET_Main_406.onnx
MDX
vocals* (10.4), instrumental (15.3)
MDX-Net Model VIP: UVR-MDX-NET_Main_406
UVR-MDX-NET_Main_427.onnx
MDX
vocals* (10.2), instrumental (15.5)
MDX-Net Model VIP: UVR-MDX-NET_Main_427
UVR-MDX-NET_Main_438.onnx
MDX
vocals* (10.1), instrumental (15.3)
MDX-Net Model VIP: UVR-MDX-NET_Main_438
UVR-MDX-NET_Inst_82_beta.onnx
MDX
instrumental* (14.3), vocals (8.2)
MDX-Net Model VIP: UVR-MDX-NET_Inst_82_beta
UVR-MDX-NET_Inst_90_beta.onnx
MDX
instrumental* (13.9), vocals (8.1)
MDX-Net Model VIP: UVR-MDX-NET_Inst_90_beta
UVR-MDX-NET_Inst_187_beta.onnx
MDX
instrumental* (14.3), vocals (8.5)
MDX-Net Model VIP: UVR-MDX-NET_Inst_187_beta
UVR-MDX-NET-Inst_full_292.onnx
MDX
instrumental* (15.1), vocals (8.5)
MDX-Net Model VIP: UVR-MDX-NET-Inst_full_292
htdemucs_ft.yaml
Demucs
vocals (10.8), drums (10.0), bass (12.0), other
Demucs v4: htdemucs_ft
htdemucs.yaml
Demucs
vocals (9.9), drums (9.4), bass (11.6), other
Demucs v4: htdemucs
hdemucs_mmi.yaml
Demucs
vocals (10.2), drums (9.6), bass (12.2), other
Demucs v4: hdemucs_mmi
htdemucs_6s.yaml
Demucs
vocals (9.6), drums (8.5), bass (10.1), guitar, piano, other
Demucs v4: htdemucs_6s
MDX23C-8KFFT-InstVoc_HQ.ckpt
MDXC
vocals (10.6), instrumental (15.8)
MDX23C Model: MDX23C-InstVoc HQ
MDX23C_D1581.ckpt
MDXC
vocals (10.0), instrumental (15.5)
MDX23C Model VIP: MDX23C_D1581
MDX23C-8KFFT-InstVoc_HQ_2.ckpt
MDXC
vocals (10.5), instrumental (15.9)
MDX23C Model VIP: MDX23C-InstVoc HQ 2
model_bs_roformer_ep_317_sdr_12.9755.ckpt
MDXC
vocals* (11.8), instrumental (16.5)
Roformer Model: BS-Roformer-Viperx-1297
model_bs_roformer_ep_368_sdr_12.9628.ckpt
MDXC
vocals* (12.1), instrumental (16.3)
Roformer Model: BS-Roformer-Viperx-1296
model_bs_roformer_ep_937_sdr_10.5309.ckpt
MDXC
no drum-bass*, drum-bass
Roformer Model: BS-Roformer-Viperx-1053
model_mel_band_roformer_ep_3005_sdr_11.4360.ckpt
MDXC
vocals* (10.5), instrumental (15.1)
Roformer Model: Mel-Roformer-Viperx-1143
melband_roformer_inst_v1.ckpt
MDXC
instrumental* (15.9), vocals (9.8)
Roformer Model: MelBand Roformer Kim | Inst V1 by Unwa
melband_roformer_inst_v2.ckpt
MDXC
instrumental* (16.1), vocals (10.3)
Roformer Model: MelBand Roformer Kim | Inst V2 by Unwa
melband_roformer_instvoc_duality_v1.ckpt
MDXC
vocals (11.0), instrumental (16.1)
Roformer Model: MelBand Roformer Kim | InstVoc Duality V1 by Unwa
melband_roformer_instvox_duality_v2.ckpt
MDXC
vocals (11.0), instrumental (16.1)
Roformer Model: MelBand Roformer Kim | InstVoc Duality V2 by Unwa
MDX23C-De-Reverb-aufr33-jarredou.ckpt
MDXC
dry, no dry
MDX23C Model: MDX23C De-Reverb by aufr33-jarredou
MDX23C-DrumSep-aufr33-jarredou.ckpt
MDXC
kick, snare, toms, hh, ride, crash
MDX23C Model: MDX23C DrumSep by aufr33-jarredou
mel_band_roformer_karaoke_aufr33_viperx_sdr_10.1956.ckpt
MDXC
vocals* (8.4), instrumental (14.7)
Roformer Model: Mel-Roformer-Karaoke-Aufr33-Viperx
mel_band_roformer_karaoke_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Karaoke by Gabox
mel_band_roformer_karaoke_gabox_v2.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Karaoke V2 by Gabox
mel_band_roformer_karaoke_becruily.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Karaoke by becruily
denoise_mel_band_roformer_aufr33_sdr_27.9959.ckpt
MDXC
dry*, other
Roformer Model: Mel-Roformer-Denoise-Aufr33
denoise_mel_band_roformer_aufr33_aggr_sdr_27.9768.ckpt
MDXC
dry*, other
Roformer Model: Mel-Roformer-Denoise-Aufr33-Aggr
mel_band_roformer_denoise_debleed_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Denoise-Debleed by Gabox
mel_band_roformer_crowd_aufr33_viperx_sdr_8.7144.ckpt
MDXC
crowd*, other
Roformer Model: Mel-Roformer-Crowd-Aufr33-Viperx
deverb_bs_roformer_8_384dim_10depth.ckpt
MDXC
noreverb*, reverb
Roformer Model: BS-Roformer-De-Reverb
vocals_mel_band_roformer.ckpt
MDXC
vocals* (12.6), other
Roformer Model: MelBand Roformer | Vocals by Kimberley Jensen
mel_band_roformer_kim_ft_unwa.ckpt
MDXC
vocals* (12.4), other
Roformer Model: MelBand Roformer Kim | FT by unwa
mel_band_roformer_kim_ft2_unwa.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer Kim | FT 2 by unwa
mel_band_roformer_kim_ft2_bleedless_unwa.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer Kim | FT 2 Bleedless by unwa
mel_band_roformer_kim_ft3_unwa.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer Kim | FT 3 by unwa
melband_roformer_inst_v1_plus.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer Kim | Inst V1 Plus by Unwa
melband_roformer_inst_v1e.ckpt
MDXC
instrumental* (15.8), vocals (9.6)
Roformer Model: MelBand Roformer Kim | Inst V1 (E) by Unwa
melband_roformer_inst_v1e_plus.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer Kim | Inst V1 (E) Plus by Unwa
bs_roformer_vocals_revive_unwa.ckpt
MDXC
Unknown
Roformer Model: BS Roformer | Vocals Revive by Unwa
bs_roformer_vocals_revive_v2_unwa.ckpt
MDXC
Unknown
Roformer Model: BS Roformer | Vocals Revive V2 by Unwa
bs_roformer_vocals_revive_v3e_unwa.ckpt
MDXC
Unknown
Roformer Model: BS Roformer | Vocals Revive V3e by Unwa
mel_band_roformer_vocals_becruily.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Vocals by becruily
mel_band_roformer_instrumental_becruily.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental by becruily
mel_band_roformer_vocal_fullness_aname.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Vocals Fullness by Aname
bs_roformer_vocals_gabox.ckpt
MDXC
Unknown
Roformer Model: BS Roformer | Vocals by Gabox
mel_band_roformer_vocals_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Vocals by Gabox
mel_band_roformer_vocals_v2_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Vocals V2 by Gabox
mel_band_roformer_vocals_fv1_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Vocals FV1 by Gabox
mel_band_roformer_vocals_fv2_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Vocals FV2 by Gabox
mel_band_roformer_vocals_fv3_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Vocals FV3 by Gabox
mel_band_roformer_vocals_fv4_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Vocals FV4 by Gabox
mel_band_roformer_vocals_fv5_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Vocals FV5 by Gabox
mel_band_roformer_vocals_fv6_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Vocals FV6 by Gabox
mel_band_roformer_instrumental_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental by Gabox
mel_band_roformer_instrumental_2_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental 2 by Gabox
mel_band_roformer_instrumental_3_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental 3 by Gabox
mel_band_roformer_instrumental_bleedless_v1_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental Bleedless V1 by Gabox
mel_band_roformer_instrumental_bleedless_v2_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental Bleedless V2 by Gabox
mel_band_roformer_instrumental_bleedless_v3_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental Bleedless V3 by Gabox
mel_band_roformer_instrumental_fullness_v1_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental Fullness V1 by Gabox
mel_band_roformer_instrumental_fullness_v2_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental Fullness V2 by Gabox
mel_band_roformer_instrumental_fullness_v3_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental Fullness V3 by Gabox
mel_band_roformer_instrumental_fullness_noise_v4_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental Fullness Noisy V4 by Gabox
mel_band_roformer_instrumental_instv5_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | INSTV5 by Gabox
mel_band_roformer_instrumental_instv5n_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | INSTV5N by Gabox
mel_band_roformer_instrumental_instv6_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | INSTV6 by Gabox
mel_band_roformer_instrumental_instv6n_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | INSTV6N by Gabox
mel_band_roformer_instrumental_instv7_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | INSTV7 by Gabox
mel_band_roformer_instrumental_instv7n_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | INSTV7N by Gabox
mel_band_roformer_instrumental_instv8_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | INSTV8 by Gabox
mel_band_roformer_instrumental_instv8n_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | INSTV8N by Gabox
mel_band_roformer_instrumental_fv7z_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental FV7z by Gabox
mel_band_roformer_instrumental_fv8_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental FV8 by Gabox
mel_band_roformer_instrumental_fvx_gabox.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Instrumental FVX by Gabox
dereverb_mel_band_roformer_anvuew_sdr_19.1729.ckpt
MDXC
noreverb*, reverb
Roformer Model: MelBand Roformer | De-Reverb by anvuew
dereverb_mel_band_roformer_less_aggressive_anvuew_sdr_18.8050.ckpt
MDXC
noreverb*, reverb
Roformer Model: MelBand Roformer | De-Reverb Less Aggressive by anvuew
dereverb_mel_band_roformer_mono_anvuew.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | De-Reverb Mono by anvuew
dereverb_big_mbr_ep_362.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | De-Reverb Big by Sucial
dereverb_super_big_mbr_ep_346.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | De-Reverb Super Big by Sucial
dereverb-echo_mel_band_roformer_sdr_10.0169.ckpt
MDXC
dry, no dry
Roformer Model: MelBand Roformer | De-Reverb-Echo by Sucial
dereverb-echo_mel_band_roformer_sdr_13.4843_v2.ckpt
MDXC
dry*, no dry
Roformer Model: MelBand Roformer | De-Reverb-Echo V2 by Sucial
dereverb_echo_mbr_fused.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | De-Reverb-Echo Fused by Sucial
MelBandRoformerSYHFT.ckpt
MDXC
vocals* (8.0), other
Roformer Model: MelBand Roformer Kim | SYHFT by SYH99999
MelBandRoformerSYHFTV2.ckpt
MDXC
vocals* (8.6), other
Roformer Model: MelBand Roformer Kim | SYHFT V2 by SYH99999
MelBandRoformerSYHFTV2.5.ckpt
MDXC
vocals* (8.5), other
Roformer Model: MelBand Roformer Kim | SYHFT V2.5 by SYH99999
MelBandRoformerSYHFTV3Epsilon.ckpt
MDXC
vocals* (9.5), other
Roformer Model: MelBand Roformer Kim | SYHFT V3 by SYH99999
MelBandRoformerBigSYHFTV1.ckpt
MDXC
vocals* (12.3), other
Roformer Model: MelBand Roformer Kim | Big SYHFT V1 by SYH99999
melband_roformer_big_beta4.ckpt
MDXC
vocals* (12.5), other
Roformer Model: MelBand Roformer Kim | Big Beta 4 FT by unwa
melband_roformer_big_beta5e.ckpt
MDXC
vocals* (12.4), other
Roformer Model: MelBand Roformer Kim | Big Beta 5e FT by unwa
melband_roformer_big_beta6.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Big Beta 6 by unwa
melband_roformer_big_beta6x.ckpt
MDXC
Unknown
Roformer Model: MelBand Roformer | Big Beta 6X by unwa
model_chorus_bs_roformer_ep_267_sdr_24.1275.ckpt
MDXC
male, female
Roformer Model: BS Roformer | Chorus Male-Female by Sucial
bs_roformer_male_female_by_aufr33_sdr_7.2889.ckpt
MDXC
Unknown
Roformer Model: BS Roformer | Male-Female by aufr33
aspiration_mel_band_roformer_sdr_18.9845.ckpt
MDXC
aspiration, other
Roformer Model: MelBand Roformer | Aspiration by Sucial
aspiration_mel_band_roformer_less_aggr_sdr_18.1201.ckpt
MDXC
aspiration, other
Roformer Model: MelBand Roformer | Aspiration Less Aggressive by Sucial
mel_band_roformer_bleed_suppressor_v1.ckpt
MDXC
instrumental*, bleed
Roformer Model: MelBand Roformer | Bleed Suppressor V1 by unwa-97chris
bs_roformer_vocals_resurrection_unwa.ckpt
MDXC
Unknown
Roformer Model: BS Roformer | Vocals Resurrection by unwa
bs_roformer_instrumental_resurrection_unwa.ckpt
MDXC
Unknown
Roformer Model: BS Roformer | Instrumental Resurrection by unwa
BS-Roformer-SW.ckpt
MDXC
Unknown
Roformer Model: BS Roformer SW by jarredou
Столбцы таблицы:
- Model Filename — имя модели
- Arch — архитектура
- Output Stems (SDR) — выводимые стемы
- Friendly Name — дружественное имя
Особое внимание обратите на выводимые стемы — в основном там вокал и инструментальная часть, но бывает и специализированный вывод. Значения в скобках означает качество вывода измеренное бенчмарком для данной стемы — чем выше значение, тем лучше разделение (но не обязательно самое приятное звучание, имеется ввиду именно чистота разделения).
Не смотря на то, что моделей здесь много и что подборка моделей весьма качественная, это далеко не все существующие для сепарации музыки модели. В данной инструкции мы будем работать с моделями из этого списка, поскольку для начала этого более чем достаточно.
Для поиска моделей вы можете использовать опцию —list_filte. Фильтрация работает не очень хорошо — в описании опции сказано что поиск выполняется по имени моделей, имени файла или любой стеме, но фактически поддерживается только поиск по стеме, причём нужно указать название стемы целиком — поиск по части слова не поддерживается.
Например:
audio-separator -l --list_filter=vocals
В качестве стемы вы можете указывать следующее:
- vocals (вокал, голос)
- instrumental (инструментах, всё кроме вокала)
- drums (ударные)
- kick, snare, toms, hh, ride, crash (элементы ударной установки: kick — бас-бочка, snare — малый барабан, toms — томы, hh — hi-hat/хай-хэт, ride — райд-тарелка, crash — крэш-тарелка)
- bass (бас)
- guitar (гитара)
- piano (пианино/фортепиано)
- other (прочее, остальные звуки не попавшие в отдельные стемы)
- woodwinds (деревянные духовые инструменты)
- reverb / noreverb (с реверберацией / без реверберации)
- male / female (мужской / женский голос)
- bleed (протечка звука между стемами, нежелательные примеси вокала в инструментальной минусовке или инструментов в вокале)
- dry (сухой сигнал, без эффектов и реверберации)
- noise (шум, шумовые помехи)
- crowd (шум толпы, аплодисменты, аудитория)
- aspiration (дыхание вокалиста, придыхания)
- drum-bass (совмещённый стем ударных и баса)
Для поиска по части слова или части названия модели используйте команду вида (замените MODEL_PROPERTY на слово для поиска):
audio-separator -l | grep -i MODEL_PROPERTY
Например:
audio-separator -l | grep -i reverb
С помощью такого подхода вы можете найти модели по части имени или описания, а также узкоспециализированные модели, в том числе по следующим ключевым словам:
- resurrection (агрессивное восстановление/очистка вокала или инструментала после артефактов и потерь сепарации аудио)
- revive (восстановленный/улучшенный вокал после сепарации вокала)
- fullness (вариант стемы с более «полным», насыщенным звучанием, обычно с сохранением хвостов и атмосферы)
- instrumental / inst / karaoke (инструментал, музыка без вокала; karaoke обычно означает тот же инструментал для караоке, либо делает акцент на удаление именно лидирующего вокала)
- denoise (шумоподавленная дорожка, уменьшение фонового шума)
- debleed / bleedless (дорожка с уменьшенным «протеканием» других стем, например просачивания вокала в инструментал)
- noisy (вариант с сохранённой частью шума/атмосферы для более естественного звучания)
- dereverb / de-reverb (удаление реверберации, эха помещения)
- dereverb-echo (удаление одновременно реверберации и выраженного эха)
- mono (моно-версия обработанной дорожки)
- male (мужской вокал)
- female (женский вокал)
- male-female (разделение мужского и женского вокала на отдельные дорожки)
Выше уже показаны примеры команд как использовать модели по вашему выбору — вы можете продолжить экспериментировать с предложенными выше или с любыми другими моделями из полного списка. Повторюсь ещё раз — нет такого понятия как «самая лучшая модель для разделения трека на дорожки», поскольку для разных жанров может лучше работать та или иная модель. Также выбор модели зависит от целей: некоторые модели чище отделяют вокал, или делают инструментальную минусовку, а другие модели делают более приятное звучание при разделении вокала и музыки.
8. Как извлечь партии музыкальных инструментов из песни. Разделение на стемы
Имеются модели которые разделяют песню сразу на отдельные инструменты. К примеру, модель BS-Roformer-SW.ckpt сохраняет следующие стемы:
- vocals (пение)
- guitar (гитара)
- piano (пианино)
- bass (бас)
- drums (барабаны)
- other (прочее)
Команда для сепарации аудио с сохранением отдельных стем пения, гитары, пианино, баса, барабанов и оставшихся инструментов:
audio-separator -m BS-Roformer-SW.ckpt "FILE.flac"
Конкретный пример:
audio-separator -m BS-Roformer-SW.ckpt "Emilíana Torrini - Jungle Drum (Official Video) (96kbit_AAC).m4a"
Файлы отдельных стем:
- Emilíana Torrini — Jungle Drum (Official Video) (96kbit_AAC)_(bass)_BS-Roformer-SW.flac
- Emilíana Torrini — Jungle Drum (Official Video) (96kbit_AAC)_(drums)_BS-Roformer-SW.flac
- Emilíana Torrini — Jungle Drum (Official Video) (96kbit_AAC)_(vocals)_BS-Roformer-SW.flac
- Emilíana Torrini — Jungle Drum (Official Video) (96kbit_AAC)_(guitar)_BS-Roformer-SW.flac
- Emilíana Torrini — Jungle Drum (Official Video) (96kbit_AAC)_(other)_BS-Roformer-SW.flac
- Emilíana Torrini — Jungle Drum (Official Video) (96kbit_AAC)_(piano)_BS-Roformer-SW.flac
Исходная песня — развернуть
И ещё один пример:
audio-separator -m BS-Roformer-SW.ckpt "Когда ты грустишь (128kbit_AAC).m4a"
Файлы отдельных стем:
- Когда ты грустишь (128kbit_AAC)_(piano)_BS-Roformer-SW.flac
- Когда ты грустишь (128kbit_AAC)_(guitar)_BS-Roformer-SW.flac
- Когда ты грустишь (128kbit_AAC)_(other)_BS-Roformer-SW.flac
- Когда ты грустишь (128kbit_AAC)_(vocals)_BS-Roformer-SW.flac
Также были созданы ещё две дорожки которые фактически пустые, поскольку этих музыкальных партий в песне нейросеть не нашла:
- Когда ты грустишь (128kbit_AAC)_(drums)_BS-Roformer-SW.flac
- Когда ты грустишь (128kbit_AAC)_(bass)_BS-Roformer-SW.flac
Исходная песня — развернуть
Модель htdemucs_ft.yaml разделяет песни на 4 стемы: vocals, drums, bass, other.
htdemucs_ft обычно считается лучшим из классических Demucs. Пример использования:
audio-separator -m htdemucs_ft.yaml "FILE.flac"
Для лучшего качества (ценой дополнительного времени и большего потребления VRAM) вы можете использовать следующие опции:
audio-separator -m htdemucs_ft.yaml --demucs_segment_size=200 --demucs_shifts=8 --demucs_overlap=0.5 "FILE.flac"
Имеется модель Demucs которая разделяет на 6 стем: vocals, drums, bass, guitar, piano, other. Пример использования:
audio-separator -m htdemucs_6s.yaml FILE.flac
Дополнительные опции для лучшего качества:
audio-separator -m htdemucs_6s.yaml --demucs_segment_size=200 --demucs_shifts=8 --demucs_overlap=0.5 FILE.flac
Всего в Audio Separator 4 модели с архитектурой Demucs, но официальный Demucs поддерживает большее количество моделей, среди которых не хотелось бы пропустить mdx_extra. Чтобы попробовать эту модель, установите Demucs (прямо в окружение Audio Separator):
pip install demucs torchcodec
Затем вы можете использовать эту модель следующим образом:
demucs -n mdx_extra FILE.flac
Усиленный вариант для лучшего качества (требуется больше времени и VRAM):
demucs -n mdx_extra --segment=200 --shifts=8 --overlap=0.5 FILE.flac
Также дорожки инструментов из песни можно выделять с помощью узкоспециализированных моделей, которые вы можете найти по следующим ключевым словам:
- drums (ударные)
- kick, snare, toms, hh, ride, crash (элементы ударной установки: kick — бас-бочка, snare — малый барабан, toms — томы, hh — hi-hat/хай-хэт, ride — райд-тарелка, crash — крэш-тарелка)
- bass (бас)
- woodwinds (деревянные духовые инструменты)
- drum-bass (совмещённый стем ударных и баса)
9. Ансамбль моделей (ensemble) для максимального качество в сепарации аудио
Существует мнение, что лучших результатов отделения вокала от музыки можно достичь комбинированием моделей (ensemble).
Выше уже показано как можно найти модели для дополнительной обработки шума, просочившихся звуков из других стем и прочего. Но под ensemble подразумевается нечто другое: аудио обрабатывается не последовательно каждой моделью, а одновременно; затем полученные результаты объединяются с помощью одного из алгоритмов.
В Audio Separator уже имеется несколько пресетов, их список выводит команда:
audio-separator --list_presets
Эти пресеты хранятся в файле ensemble_presets.json. Путь до этого файла (если вы установили Audio Separator по инструкции этой статьи): ~/.local/share/mamba/envs/audio-separator/lib/python3.12/site-packages/audio_separator/ensemble_presets.json
Описание пресетов ансамблей моделей Audio Separator:
Пример использования пресета:
audio-separator --ensemble_preset karaoke "FILE.flac"
Кроме использования готовых пресетов, вы можете создавать ансамбли моделей указывая их прямо в строке команды.
Для этого вы можете использовать следующую совокупность опций:
- -m MODEL_FILENAME: основная модель используемая для сепарации аудио. Пример: -m model1.ckpt
- —extra_models EXTRA_MODELS [EXTRA_MODELS …]: дополнительные модели для ансамблирования. Можно указать одну или больше моделей. Пример: —extra_models model2.onnx model3.ckpt
- —ensemble_algorithm: алгоритм используемый в ансамбле моделей (по умолчанию avg_wave). Доступные алгоритмы: avg_wave, median_wave, min_wave, max_wave, avg_fft, median_fft, min_fft, max_fft, uvr_max_spec, uvr_min_spec, ensemble_wav. Пример: —ensemble_algorithm=uvr_max_spec
- —ensemble_weights ENSEMBLE_WEIGHTS [ENSEMBLE_WEIGHTS …]: Веса для ансамблирования нескольких моделей (по умолчанию: равны). Количество весов должно соответствовать количеству моделей. Пример: —ensemble_weights 1.0 0.5
Все эти опции кроме —extra_models имеют значения по умолчанию и могут быть пропущены.
Алгоритмы ансамбля моделей:
- avg_wave – Взвешенное усреднение waveforms; наиболее универсальный и безопасный режим для общего улучшения качества и снижения случайных артефактов
- median_wave – Медиана waveforms; хорошо удаляет выбросы и нестабильные артефакты между моделями, полезно для cleaner stems
- min_wave – Минимум waveforms; агрессивно подавляет лишние сигналы и bleed, но может ослаблять полезный звук
- max_wave – Максимум waveforms; сохраняет максимум деталей и ревербераций, но часто усиливает шумы и bleed
- avg_fft – Взвешенное усреднение спектрограмм; обычно даёт более чистый частотный баланс и меньше фазовых проблем, чем wave averaging
- median_fft – Медиана спектрограмм; эффективно устраняет спектральные артефакты и «музыкальный шум», особенно в ensemble из разных моделей
- min_fft – Минимум спектрограмм; подходит для агрессивной очистки вокала или инструментала от остаточных компонентов
- max_fft – Максимум спектрограмм; сохраняет максимум спектральной информации и атмосферы, но может увеличивать шум и кашу
- uvr_max_spec – UVR-алгоритм максимального спектрального объединения; часто используется для более «полного» звучания инструменталов и сохранения хвостов реверберации
- uvr_min_spec – UVR-алгоритм минимального спектрального объединения; ориентирован на минимизацию bleed и артефактов в clean stems
- ensemble_wav – Chunk-based UVR ensemble с выбором наименее шумных фрагментов; полезен для нестабильных моделей и сложных миксов с локальными артефактами
Примеры использования пресетов ансамблей в Audio Separator:
1.
audio-separator --ensemble_preset vocal_rvc "Гном Миша пчеловод.mp3"
Результаты:
- Гном Миша пчеловод_(Vocals)_preset_vocal_rvc.flac
- Гном Миша пчеловод_(Instrumental)_preset_vocal_rvc.flac
Исходная песня:
2.
audio-separator --ensemble_preset instrumental_full "EURODACER - I Think of Swing (www.eurodanceperu.com) (152kbit_Opus).opus"
Результаты:
- EURODACER — I Think of Swing (www.eurodanceperu.com) (152kbit_Opus)_(Instrumental)_preset_instrumental_full.flac
- EURODACER — I Think of Swing (www.eurodanceperu.com) (152kbit_Opus)_(Vocals)_preset_instrumental_full.flac
Исходная песня — развернуть
3.
audio-separator --ensemble_preset karaoke "08 - A Neverending Dream [555 Version].flac"
Результаты:
- 08 — A Neverending Dream [555 Version]_(Instrumental)_preset_karaoke.flac
- 08 — A Neverending Dream [555 Version]_(Vocals)_preset_karaoke.flac
Исходная песня — развернуть
10. Как удалить остатки музыки из голоса, а также как удалить остатки пения из инструментальной минусовки
Типичной проблемой разделения аудио на стемы является просачивания звуков из одной стемы в другую. С этой проблемой можно бороться используя как минимум 2 подхода:
- Выполнить сепарацию аудио с помощью других моделей или ансамбля моделей — есть шанс что другие модели сработают лучше.
- Продолжить обработку получившихся дорожек с помощью моделей предназначенных специально для таких случаев очистки от остатков голоса или музыкальных инструментов
Для последующей обработки стем после разделения ищите модели в названии или описании которых есть слова: bleed, debleed, bleedless, resurrection, revive.
Подбор моделей для деблидинга голоса:
- mel_band_roformer_kim_ft2_bleedless_unwa.ckpt
- mel_band_roformer_denoise_debleed_gabox.ckpt
- bs_roformer_vocals_resurrection_unwa.ckpt
- bs_roformer_vocals_revive_v3e_unwa.ckpt
Подбор моделей для деблидинга инструментальной минусовки:
- mel_band_roformer_bleed_suppressor_v1.ckpt
- mel_band_roformer_instrumental_bleedless_v3_gabox.ckpt
- bs_roformer_instrumental_resurrection_unwa.ckpt
Пример использования:
audio-separator -m bs_roformer_vocals_revive_v3e_unwa.ckpt "01. You'll Be Mine_(Vocals)_preset_vocal_balanced.flac"
11. Как удалить шум, эхо и реверберацию из пения с помощью нейросетей
Для последующей обработки голоса после извлечения звуковой дорожки используйте специализированные модели которые вы можете найти по следующим словам:
- denoise (шумоподавленная дорожка, уменьшение фонового шума).
- dereverb / de-reverb (удаление реверберации, эха помещения)
- dereverb-echo (удаление одновременно реверберации и выраженного эха)
- dry (сухой сигнал, без эффектов и реверберации)
- noise (шум, шумовые помехи)
- crowd (шум толпы, аплодисменты, аудитория)
- aspiration (дыхание вокалиста, придыхания)
- reverb / noreverb (с реверберацией / без реверберации)
Пример использования:
audio-separator -m dereverb-echo_mel_band_roformer_sdr_13.4843_v2.ckpt "01. You'll Be Mine_(Vocals)_preset_vocal_balanced.flac"
12. Как разделять голос и инструментальную часть в длинных песнях
Обработка очень длинных аудио может потребовать большое количество видеопамяти и завершиться неудачей если памяти не хватит. Чтобы обрабатывать файлы любой длины, их лучше разбивать на куски. Причём вам не нужно это делать вручную поскольку имеется специальная опций:
- —chunk_duration CHUNK_DURATION Разделяет аудио на куски указанной длительности в секундах (по умолчанию: None = без разбиения). Полезно для обработки очень длинных аудиофайлов на системах с ограниченной памятью. Рекомендуется: 600 (10 минут) для файлов >1 часа. Куски объединяются без наложений/перекрёстного плавного перехода. Пример: —chunk_duration=600
Пример использования:
audio-separator --chunk_duration 600 "FILE.flac"
13. Где Audio Separator хранит файлы моделей нейросетей. Почему Audio Separator заново скачивает файлы моделей
По умолчанию в Linux Audio Separator сохраняет файлы моделей в директории /tmp/audio-separator-models/ и это имеет сразу несколько, иногда не очень очевидных последствий:
- после перезагрузки ОС директория /tmp/ полностью очищается, то есть все файлы моделей будут удалены. Соответственно, после перезапуска компьютера при использовании Audio Separator он вновь будет скачивать файлы моделей;
- во многих современных дистрибутивах директория /tmp/ является файловой системой tmpfs, то есть фактически находится в оперативной памяти. Вы можете это проверить командой:
mount | grep /tmp
Пример вывода:
tmpfs on /tmp type tmpfs (rw,nosuid,nodev,size=31694784k,nr_inodes=1048576,inode64,huge=within_size,usrquota)
Строки tmpfs означают, что директория /tmp/ действительно хранится в оперативной памяти. То есть если программа скачала 10 гигабайт файлов моделей, то это потребует 10 гигабайт в оперативной памяти.
Плюсом этого является крайне быстрая загрузка моделей скриптами (фактически они уже в оперативной памяти) и отсутствие нагрузки на диск.
Если что-то из этого вас не устраивает, то вы можете использовать опцию —model_file_dir MODEL_FILE_DIR которая позволяет указать директорию с файлами моделей. Соответственно, модели будут сохраняться в эту папку, и Audio Separator будет искать модели именно в этой папке.
Пример указания текущей директории:
audio-separator --model_file_dir . "FILE.flac"
Примеры указания конкретной директории на диске:
audio-separator --model_file_dir ~/ai/tests/audio-separator/ "FILE.flac"
audio-separator --model_file_dir /home/mial/ai/tests/audio-separator/ "FILE.flac"
14. Полезные опции Audio Separator
Выше уже рассмотрены важнейшие опции Audio Separator, у этой программы опций больше, вы можете посмотреть их все командой:
audio-separator --help
Особенно полезно знать о следующих опциях:
- —output_format ФОРМАТ_ВЫВОДА: Формат вывода для файлов разделённого аудио (по умолчанию: FLAC). Пример: —output_format=MP3
- —output_bitrate БИТРЕЙТ_ВЫВОДА: Битрейт для разделённых файлов, любой совместимый с ffmpeg битрейт (по умолчанию: None). Пример: —output_bitrate=320k
- —output_dir ДИРЕКТОРИЯ_ВЫВОДА: Каталог для записи выходных файлов (по умолчанию: текущая рабочая директория). Пример: —output_dir=/app/separated
15. Как конвертировать FLAC в MP3
По умолчанию Audio Separator сохраняет файлы в формате FLAC — это популярный формат, который хорошо поддерживается во всех операционных системах и браузерах. Его главной особенностью является сжатие аудио без потерь, хотя файлы при этом имеют больший размер чем MP3 (самый популярный формат сжатия аудио с потерями). Ниже даны команды которыми вы можете конвертировать файлы FLAC в MP3.
Для конвертации файла FILE.flac в файл FILE.mp3 с переменным битрейтом выполните команду:
ffmpeg -i 'FILE.flac' -codec:a libmp3lame -qscale:a 0 'FILE.mp3'
Для конвертации файла FILE.flac в файл FILE.mp3 с фиксированным битрейтом 320 kbps выполните команду:
ffmpeg -i 'FILE.flac' -codec:a libmp3lame -b:a 320k 'FILE.mp3'
Чтобы конвертировать все файлы FLAC в текущей директории в формат MP3 с переменным битрейтом выполните следующий код (можно скопировать и вставить в консоль сразу все строки), затем нажмите Enter:
for f in *.flac; do
	ffmpeg -i "$f" -codec:a libmp3lame -qscale:a 0 "${f%.flac}.mp3"
done
Чтобы конвертировать все файлы FLAC в текущей директории в формат MP3 с фиксированным битрейтом 320 kbps выполните следующий код (можно скопировать и вставить в консоль сразу все строки), затем нажмите Enter:
for f in *.flac; do
	ffmpeg -i "$f" -codec:a libmp3lame -b:a 320k "${f%.flac}.mp3"
done
Заключение
В этой инструкции мы рассмотрели программу Audio Separator для отделения голоса от музыкальных инструментов. Audio Separator это не единственная и даже не самая популярная программа для этих целей (хотя, пожалуй, самая актуальная). Например, ещё есть UVR (Ultimate Vocal Remover) — кроссплатформенная программа с графическим интерфейсам. Официальный Ultimate Vocal Remover в настоящее время заброшен, но имеются версии от сообщества, которые работают с современными версиями Python.
Что касается моделей, то если объединить списки Audio Separator и Ultimate Vocal Remover, то всё равно не будут охвачены все модели. Имеются коллекции с огромными подборками современных и устаревших файлов моделей. К тому же, в настоящее время продолжают тренировать новые модели от энтузиастов.
То есть у этой темы может быть продолжение:
- как установить и использовать актуальную версию UVR (Ultimate Vocal Remover)
- как запускать любые модели для сепарации аудио даже если они не попали в Audio Separator и Ultimate Vocal Remover
- где найти и как запускать новейшие версии моделей, которые вышли в последние месяцы и которые продолжают выходить
- локальный запуск модели MVSep Mega разделяющей аудио на 53 стемы ('accordion', 'acoustic-guitar', 'back-vocal', 'banjo', 'bass', 'bassoon', 'bells', 'bowed_strings', 'brass', 'cello', 'clarinet', 'congas', 'digital-piano', 'dobro', 'double-bass', 'drums', 'electric-guitar', 'flute', 'french-horn', 'glockenspiel', 'guitar', 'harmonica', 'harp', 'harpsichord', 'hh', 'keys', 'kick', 'lead-vocal', 'mandolin', 'marimba', 'oboe', 'organ', 'percussion', 'piano', 'saxophone', 'sitar', 'snare', 'strings', 'synth', 'tambourine', 'timpani', 'toms', 'triangle', 'trombone', 'trumpet', 'tuba', 'ukulele', 'viola', 'violin', 'vocal', 'wind', 'wind-chimes', 'woodwind').
Как обычно, делитесь ссылкой на эту статью — при большом количестве просмотров и интереса будут дописаны продолжения.
Связанные статьи:
- Локальный TTS на 30 языках с клонированием голоса (инструкция по использованию VoxCPM2) (73.6%)
- Локальное распознавание речи на 30 языках (инструкция по использованию Qwen3-ASR-1.7B) (73.6%)
- Программа для озвучивания текстов любой длины на своём компьютере с помощью ИИ в графическом интерфейсе (73.6%)
- 1. Как использовать нейросети для создания изображений, видео и музыки на своём компьютере — что для этого нужно и какой результат можно получить (53.8%)
- 2. Как установить ComfyUI в Windows и Linux (53.8%)
- 7. Расширение области видимости изображений с помощью нейросетей: расширение кадра, изменение соотношения сторон с добавлением новой информации (outpainting) (RANDOM - 53.8%)